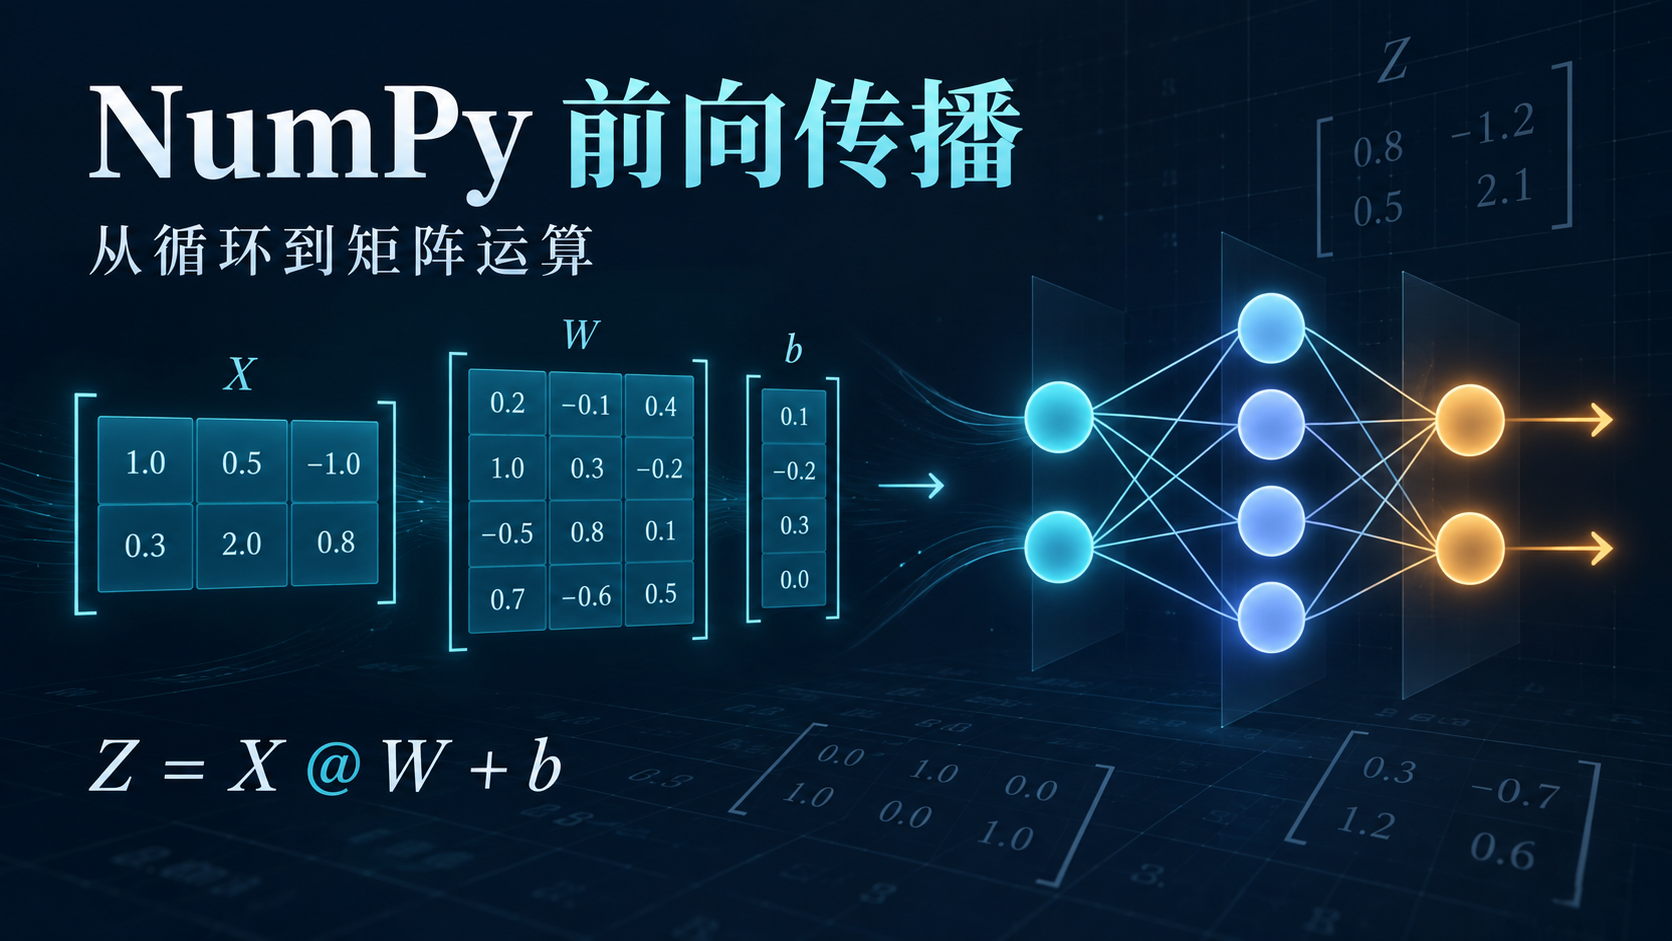
NumPy 前向传播详解:从循环到矩阵运算
从吴恩达课程中的手写前向传播出发,理解每个神经元怎样计算、矩阵的行列代表什么、为什么有时需要转置,以及一批样本如何连续通过多层网络。
本文使用同一组具体数值,把矩阵乘法、偏置广播、sigmoid 和下一层计算逐步展开。代码只依赖 NumPy;所有权重都是教学演示参数,没有经过训练。
1. 先建立一套统一的数据排列约定
本文讨论二维输入的全连接网络,使用下面的排列:
| 对象 | 行的含义 | 列的含义 | 形状 |
|---|---|---|---|
| 输入 X | 样本 | 输入特征 | (样本数, 输入特征数) |
| 权重 W | 输入特征 | 当前层神经元 | (输入特征数, 神经元数) |
| 偏置 b | 一维数组 | 每个元素对应一个神经元 | (神经元数,) |
| 加权结果 Z | 样本 | 当前层神经元 | (样本数, 神经元数) |
| 激活输出 A_out | 样本 | 当前层神经元 | (样本数, 神经元数) |
核心代码只有两步:
1 | Z = X @ W + b |
NumPy 只知道数组的维度与数值,并不知道什么是“样本”或“特征”。这些含义由我们准备数据时确定。 其他教材或实现可以使用另一种排列,公式也会相应变化。不能把某一种权重排列当成所有实现都必须遵守的规则。
2. shape[1] 到底是什么意思?
1 | W = np.array([ |
Python 下标从 0 开始,所以 shape[1] 取的是形状元组中的第二个数。
在本文的权重排列中,每列对应一个神经元。因此:
1 | units = W.shape[1] # 当前层有 3 个神经元 |
: 表示取所有行;0 表示取第 0 列。W[:, j] 得到第 j + 1 个神经元的权重向量。
shape[1] 本身只表示第二个维度的大小。 如果对象是输入 X,它通常表示特征数;如果对象是权重 W,它在本文中表示神经元数。
3. 单个神经元与循环版前向传播
一个神经元先把每个输入乘对应权重,再求和、加偏置,最后通过激活函数。
$$
z_j = \sum_{k=1}^{n} x_k w_{kj} + b_j
$$
$$
a_j = g(z_j)
$$
其中,k 表示输入特征编号,j 表示神经元编号。本文使用 sigmoid:
$$
g(z)=\frac{1}{1+e^{-z}}
$$
1 | import numpy as np |
3.1 sigmoid 的括号不能漏
1 | # 正确:整个 1 + exp(-z) 都在分母中 |
3.2 为什么课程得到接近 [1, 0, 1]?
这一页课件使用:
1 | x = np.array([200, 17]) |
| 神经元 | z 的计算 | 激活值 |
|---|---|---|
| 第 1 个 | 200×1 + 17×(-2) - 1 = 165 | 约 1 |
| 第 2 个 | 200×(-3) + 17×4 + 1 = -531 | 约 2.45261912e-231 |
| 第 3 个 | 200×5 + 17×(-6) + 2 = 900 | 约 1 |
所以显示结果接近 [1, 0, 1]。这里是在描述激活值的近似值,没有额外做阈值分类。数学上,有限实数的 sigmoid 严格介于 0 和 1 之间;计算机可能因浮点舍入显示或存储为 1。
如果换成输入 [-2, 4],并把 W 第二行第一列改成 2,对应的 z 就是 [5, 23, -32],输出接近 [1, 1, 0]。输入和参数不同,输出就不同。
4. 转置会不会改变特征?
看下面这份原始数组:
1 | A = np.array([ |
只看到形状 (2, 3),无法断言它一定是 2 个样本、3 个特征:要先知道作者如何组织数据。
4.1 如果每列是一个样本
| 原始 A | 样本 1 | 样本 2 | 样本 3 |
|---|---|---|---|
| 特征 1 | 1 | -1 | 0.1 |
| 特征 2 | 2 | -2 | 0.2 |
此时样本 1 的特征是 [1, 2]。为了符合本文“每行一个样本”的计算约定,可以转置:
1 | X = A.T |
样本 1 仍然是 [1, 2],只是从一列变成一行。样本数量和特征含义都没改变。
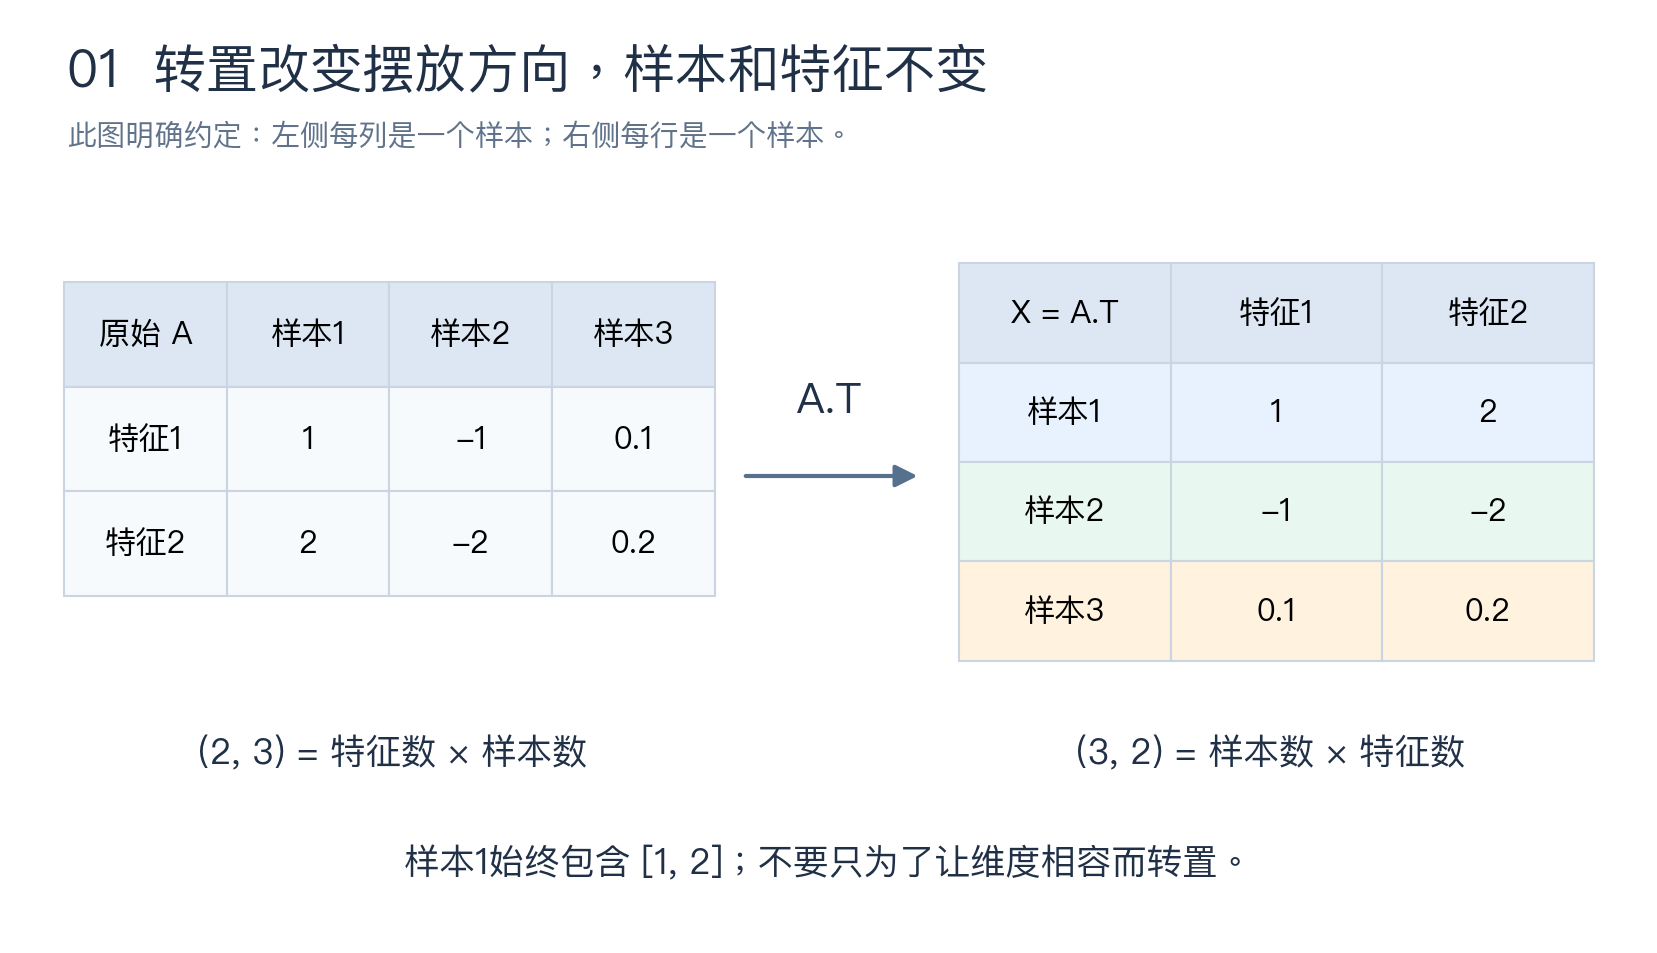
4.2 如果原来的每行已经是一个样本
如果 [1, -1, 0.1] 本来就表示一个样本的 3 个特征,那么 A 就是 2 个样本、3 个特征。此时不应该为了配合一个 2 行的 W 而转置;应该使用有 3 行的权重矩阵。
结论:先确定数据含义,再决定是否转置。既不默认转置输入,也不默认转置权重。
补充:一维数组 np.array([200, 17]) 的形状是 (2,),对它使用 .T 不会变成二维列矩阵。可用 x.reshape(1, -1) 构造一行,用 x.reshape(-1, 1) 构造一列,但仍要考虑这次变形的实际含义。
5. 从循环到矩阵乘法:计算一样,组织方式不同
后续统一使用 3 个样本、每个样本 2 个特征:
1 | X = np.array([ |
W1 每列对应一个神经元,所以第一层有 4 个神经元。每个样本都使用同一个 W1 和 b1。
| 参数 | 神经元 1 | 神经元 2 | 神经元 3 | 神经元 4 |
|---|---|---|---|---|
| 特征 1 的权重 | 3 | 5 | 7 | 9 |
| 特征 2 的权重 | 4 | 6 | 8 | 0 |
| 偏置 | -1 | 1 | 2 | 5 |
向量化版本:
1 | def dense(A_in, W, b): |
np.matmul(A_in, W) 在这里等价于 A_in @ W。循环版每次计算一列权重;矩阵版一次调用计算所有列,并可以同时处理输入的所有样本行。底层仍然要进行乘法和加法,只是交给优化过的数值运算实现,避免自己写逐项 Python 循环。
5.1 必须满足矩阵乘法的维度规则
二维情况下:
$$
(m,n)\times(n,u)\longrightarrow(m,u)
$$
| 左边形状 | 右边形状 | 是否可以相乘 | 输出形状 |
|---|---|---|---|
| (3, 2) | (2, 4) | 可以 | (3, 4) |
| (2, 3) | (2, 4) | 不可以,内侧维度不一致 | 报错 |
| (2, 3) | (3, 4) | 可以 | (2, 4) |
@ / matmul 是矩阵乘法;* 是逐元素乘法,两者不能混用。本文只展开二维情况;matmul 对一维和更高维数组还有其他规则,不能把“总是输出二维矩阵”当成它的一般性质。
5.2 矩阵中的每个结果怎么来?
例如样本 3、神经元 2 的计算:
1 | 0.1 * 5 + 0.2 * 6 # 1.7,还没加偏置 |
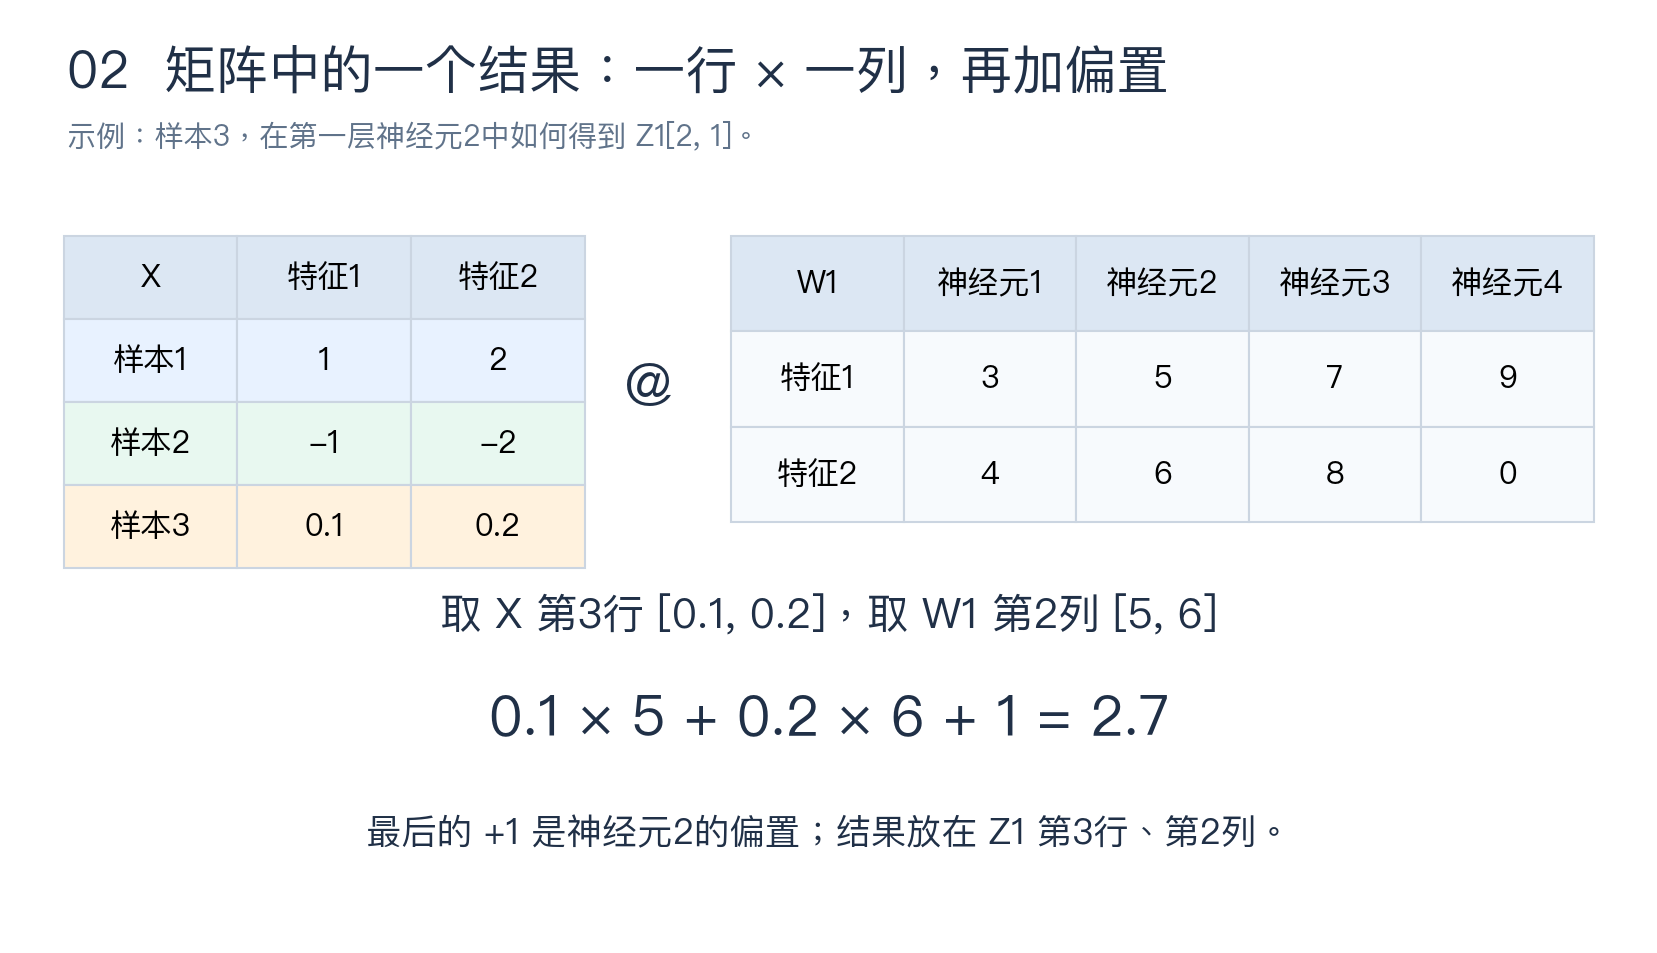
完整的 X @ W1:
| 样本 | 神经元 1 | 神经元 2 | 神经元 3 | 神经元 4 |
|---|---|---|---|---|
| 样本 1 | 11 | 17 | 23 | 9 |
| 样本 2 | -11 | -17 | -23 | -9 |
| 样本 3 | 1.1 | 1.7 | 2.3 | 0.9 |
例如样本 1 的整行是:
1 | [1*3 + 2*4, 1*5 + 2*6, 1*7 + 2*8, 1*9 + 2*0] |
6. +b 怎样处理?每一行使用同一组偏置
1 | Z1 = X @ W1 + b1 |
这里 X @ W1 的形状为 (3, 4),b1 的形状为 (4,)。NumPy 广播允许每一行都与 b1 对应相加,可以想象成下面的形式,但不需要真的复制出三行偏置:
1 | # 用于理解的等效排列 |
逐项展开:
| 样本 | 第 1 列 | 第 2 列 | 第 3 列 | 第 4 列 |
|---|---|---|---|---|
| 样本 1 | 11 - 1 = 10 | 17 + 1 = 18 | 23 + 2 = 25 | 9 + 5 = 14 |
| 样本 2 | -11 - 1 = -12 | -17 + 1 = -16 | -23 + 2 = -21 | -9 + 5 = -4 |
| 样本 3 | 1.1 - 1 = 0.1 | 1.7 + 1 = 2.7 | 2.3 + 2 = 4.3 | 0.9 + 5 = 5.9 |
因此:
1 | Z1 = np.array([ |
为什么最开始 b = [-1, 1, 2] 不行?因为有 4 个神经元,却只有 3 个偏置。(3, 4) 和 (3,) 从最右侧维度对齐时,4 与 3 不匹配。
本例中 (4,) 和 (1, 4) 的偏置都可以。广播的一般规则是:从右向左比较,各维度要么相等,要么其中一个是 1。但维度能广播并不代表神经网络含义就一定正确;本例需要的是“每个神经元一个偏置”。
参考:NumPy 广播官方文档。
7. sigmoid 接收整个矩阵,但逐元素计算
1 | def g(z): |
传进去的是 Z1,计算完成后才得到 A1,不能把这两个步骤的先后顺序反过来。
函数中的变量名 z 不限制它只能是一个数。它可以接收一个标量、一维数组,也可以接收整个二维数组。这里的 np.exp、取负、加 1 和除法都作用于每个元素。
例如 Z1 的第 3 行:
| 原始 z | sigmoid 计算 | 激活值(约) |
|---|---|---|
| 0.1 | 1 / (1 + exp(-0.1)) | 0.524979 |
| 2.7 | 1 / (1 + exp(-2.7)) | 0.937027 |
| 4.3 | 1 / (1 + exp(-4.3)) | 0.986613 |
| 5.9 | 1 / (1 + exp(-5.9)) | 0.997268 |
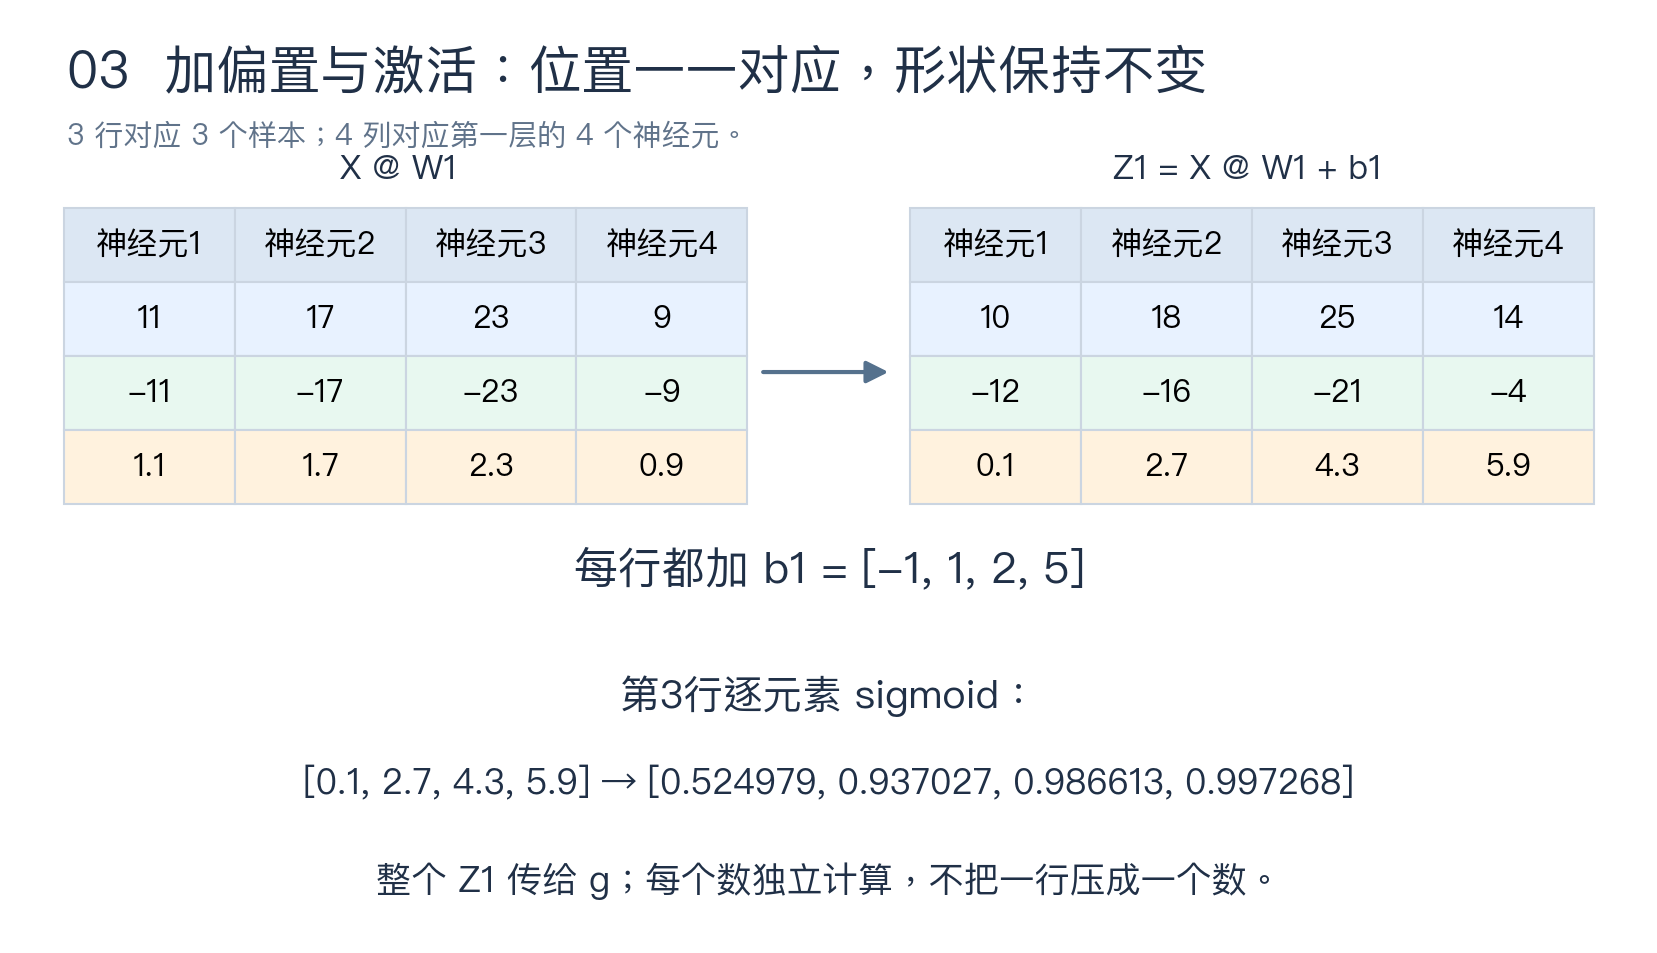
整个 A1 是:
| 样本 | 神经元 1 | 神经元 2 | 神经元 3 | 神经元 4 |
|---|---|---|---|---|
| 样本 1 | 0.999955 | 1.000000 | 1.000000 | 0.999999 |
| 样本 2 | 0.000006 | 0.000000 | 0.000000 | 0.017986 |
| 样本 3 | 0.524979 | 0.937027 | 0.986613 | 0.997268 |
表中保留六位小数,后续计算使用未四舍五入的数组。形状一直是 (3, 4):sigmoid 不把一行合成一个数,也不改变样本数和神经元数。
8. 下一层直接接收 A1
第一层输出的每行包含 4 个激活值。对于第二层,它们就是一个样本的 4 个输入特征,也可称为上一层产生的新表示。
原始特征没有被重新定义成其他样本;同一个样本只是拥有了新的表示方式。
现在增加一个有 2 个神经元的第二层:
1 | W2 = np.array([ |
为什么 W2 是 (4, 2)?因为第二层每个神经元要接收第一层的 4 个输出,而第二层共有 2 个神经元。
| 第二层接收的值 | 第二层神经元 1 的权重 | 第二层神经元 2 的权重 |
|---|---|---|
| 第一层神经元 1 的输出 | 1 | -1 |
| 第一层神经元 2 的输出 | 1 | 1 |
| 第一层神经元 3 的输出 | -1 | 1 |
| 第一层神经元 4 的输出 | 1 | -1 |
| 偏置 | -1 | 0 |
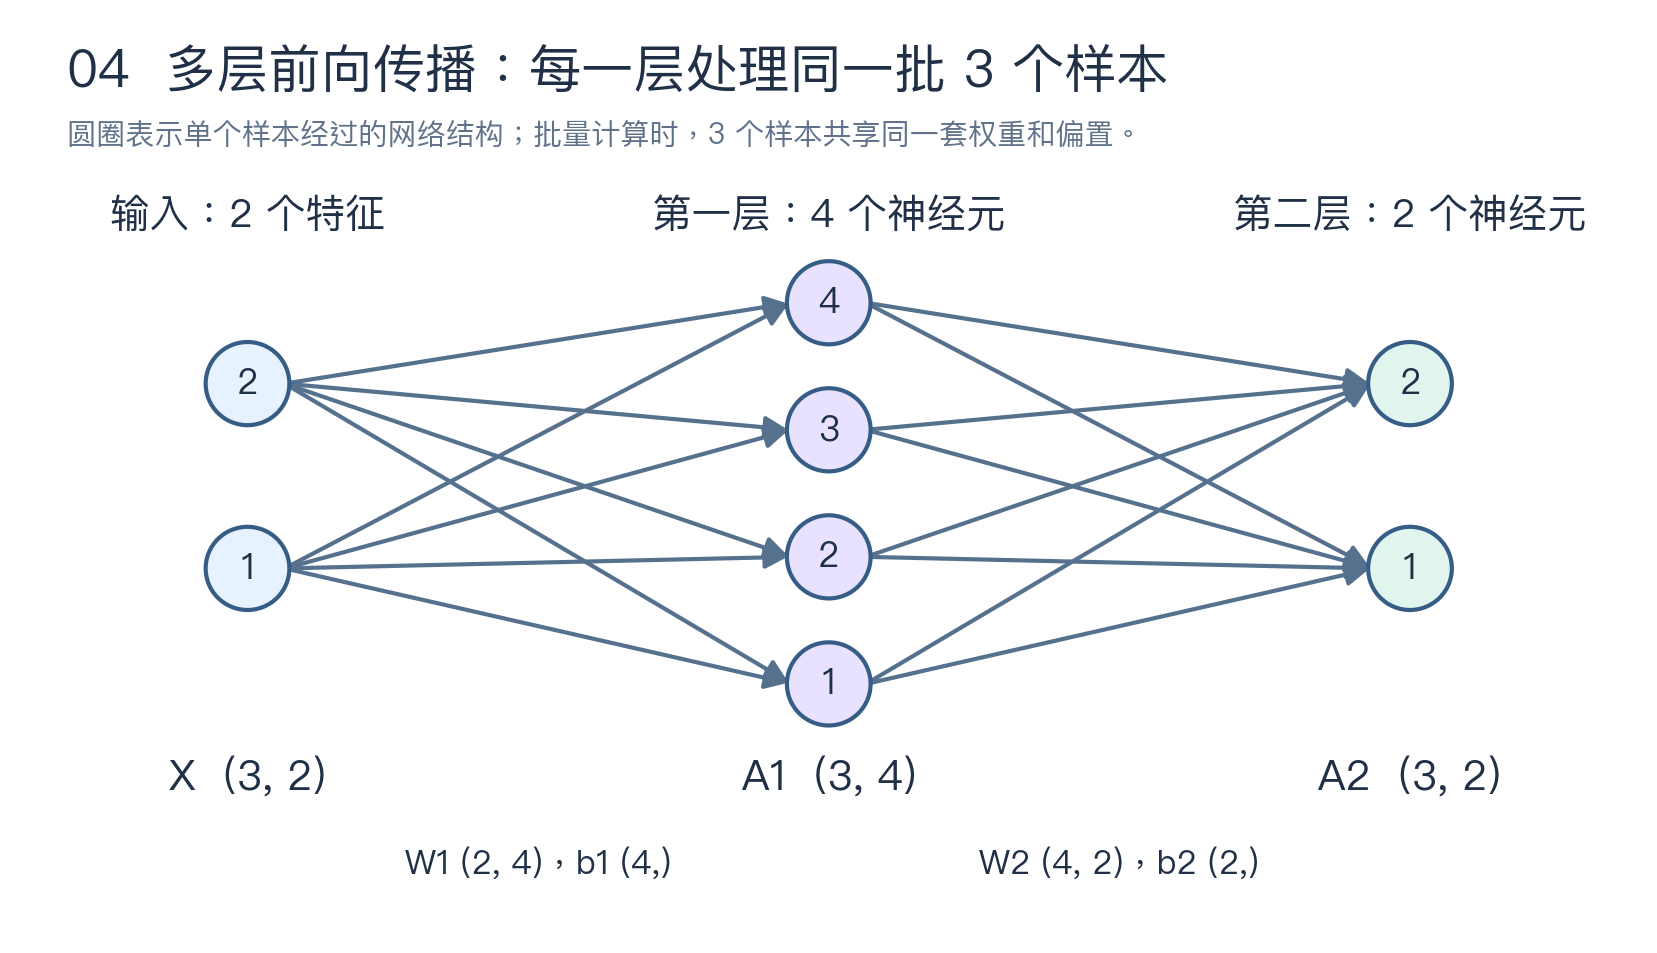
8.1 详细展开样本 3
样本 3 原始输入是 [0.1, 0.2]。到第二层时,输入变成:
1 | [0.524979, 0.937027, 0.986613, 0.997268] |
第二层神经元 1:
1 | z = (0.524979 * 1 |
第二层神经元 2:
1 | z = (0.524979 * (-1) |
于是这个样本的第二层输出是 [0.616013, 0.599022]。
8.2 所有样本的完整结果
| 样本 | Z2 第 1 列 | Z2 第 2 列 | A2 第 1 列 | A2 第 2 列 |
|---|---|---|---|---|
| 样本 1 | 0.999954 | 0.000046 | 0.731049 | 0.500012 |
| 样本 2 | -0.982008 | -0.017992 | 0.272494 | 0.495502 |
| 样本 3 | 0.472661 | 0.401392 | 0.616013 | 0.599022 |
第二层使用新的 W2、b2。上一层的 W1、b1 不会直接拿来复用。不同样本则共享同一层的参数。
这两个输出是两个独立的 sigmoid 激活值,不要求总和为 1。能否解释为某种概率,取决于训练任务和输出层设计;手动指定的演示权重没有预测质量保证。
9. 为什么样本数始终是 3?
本例每一层都对每个样本独立计算,没有把不同样本合并。
| 阶段 | 形状 | 每行的含义 |
|---|---|---|
| X | (3, 2) | 一个样本的 2 个原始特征 |
| A1 | (3, 4) | 同一个样本的 4 个第一层激活值 |
| A2 | (3, 2) | 同一个样本的 2 个第二层激活值 |
| 如果第三层有 1 个神经元 | (3, 1) | 同一个样本的 1 个第三层激活值 |
矩阵乘法把一个样本的特征组合起来,没有对样本行进行求和。A2[1, 0] 始终表示“第 2 个样本在第二层第 1 个神经元中的激活值”。
3 个样本 × 4 个神经元 = 12 个激活值,不等于有 12 个神经元。
10. 一般公式:每层重复同样的两步
输入层记为第 0 层:
$$
A^{[0]}=X
$$
对于第 l 层:
$$
Z^{[l]}=A^{[l-1]}W^{[l]}+b^{[l]}
$$
$$
A^{[l]}=g^{[l]}(Z^{[l]})
$$
这里 b 在样本维度上广播。方括号上标表示层编号,不是乘方。不同层可以使用不同的激活函数;本文两层都使用 sigmoid。
展开其中一个元素:
$$
z_{ij}^{[l]}=\sum_{k=1}^{n_{l-1}} a_{ik}^{[l-1]} w_{kj}^{[l]}+b_j^{[l]}
$$
| 符号说明 | 含义 |
|---|---|
| i | 样本编号 |
| j | 当前层神经元编号 |
| k | 上一层输出的编号;在第一层就是原始特征编号 |
| m | 当前批次的样本数 |
| n_l | 第 l 层的神经元数量 |
形状对应:
$$
(m,n_{l-1})\times(n_{l-1},n_l)\longrightarrow(m,n_l)
$$
表格中的符号使用普通文本,避免表格内数学公式未渲染的问题。
11. 完整可运行代码与验证
下面只需要安装 NumPy。代码会打印每一步,并将循环版与矩阵版进行比较。TensorFlow 的导入没有被使用,因此不需要加入。
1 | """教学用两层前向传播:3 个样本,2 → 4 → 2。只依赖 NumPy。""" |
这里完整代码返回 (Z, A_out) 两个值,方便观察中间过程;前面简写的 dense 只返回 A_out。调用时要区分两种返回形式。
为避免极端输入导致指数溢出,完整脚本使用分支计算的稳定 sigmoid;它与前面的基础公式数学等价。学习时先理解简单版本即可。
最终输出 A2 约为:
1 | [[0.731049 0.500012] |
precision=6 只设置打印精度,suppress=True 尽量使用小数显示。非常小的数可能显示为 0,并不代表中间计算时把它主动变成了 0。
12. 常见误区速查
| 疑问或误区 | 正确理解 |
|---|---|
| 输入默认都要转置? | 不需要。先确定样本、特征位于哪个轴,再匹配公式。 |
| W 默认绝对不能转置? | 本文 W 已按“输入特征 × 神经元”排列,因此直接用;其他排列要采用对应公式。 |
| 只要形状能乘就说明没问题? | 还要确保特征顺序与权重行一一对应。 |
| matmul 直接得到最终激活值? | 它只完成矩阵乘法,还要加偏置、计算激活函数。 |
| g 接收一行,把它压成一个值? | 本文 sigmoid 逐元素计算,不改变数组形状。 |
| 最后得到的是新 W? | W 是参数,计算得到的是 Z 和激活值 A_out。 |
| 3×4 个结果就是 12 个神经元? | 是 3 个样本分别经过同一层 4 个神经元的结果。 |
| 第一层和第二层使用同一份权重? | 每层有自己的参数;同一层的不同样本共享参数。 |
| 这就训练好网络了吗? | 这里只做前向传播。训练还需要损失、梯度和参数更新。 |
| 第一层有 sigmoid 就必须马上转成 0/1? | 不要在这里随意阈值化,下一层继续使用连续激活值。 |
| 最后一层 2 个 sigmoid 输出一定总和为 1? | 不要求。任务不同,输出层设计与解释也不同。 |
13. 最后记住这五句话
- 输入按“样本 × 特征”排列,权重按“输入特征 × 神经元”排列,是本文采用的约定。
- 矩阵乘法取输入的一行、权重的一列,对应相乘再求和。
- 偏置按神经元分配,所有样本共享同一组偏置。
- sigmoid 对每个元素独立计算;当前层输出直接成为下一层输入。
- 在本例全连接前向传播中,样本数不变,每个样本的表示维度由当前层神经元数决定。
回头看整个网络,其实每层都在重复:
1 | Z = A_in @ W + b |
真正需要弄清楚的是每个数组的含义、形状,以及前后两层怎样衔接。