
TensorFlow 前向传播详解:从咖啡豆案例到多层神经网络
神经网络如何把“温度和烘焙时间”变成一个预测概率?Dense(3) 为什么输出三个数?课程里的 $a_j^{[\ell]}$,右上角和右下角分别表示什么?
这篇笔记从咖啡豆烘焙案例出发,逐个神经元展开计算,再对应到 TensorFlow 代码,最后推广到课程中的手写数字识别网络。
1. 先看清网络:输入层与计算层咖啡豆案例有两个输入特征:温度与烘焙时间。示例网络包含一个有 3 个神经元的隐藏层,以及一个有 1 个神经元的输出层。
本文统一采用以下编号:
输入记为第 0 层,$a^{[0]}=x$。
第 1 层是隐藏层,输出为 $a^{[1]}$。
第 2 层是输出层,输出为 $a^{[2]}$。
因此,咖啡豆网络有 2 个参与学习的 Dense 层。输入负责提供数据,没有这一类权重与偏置。
课程手写数字截图需要特别看清:从 $x$ 后面开始,25 个神经元是第 1 个隐藏层,15 个神经元是第 2 个隐藏层,最后 1 个神经元是第 3 层,也就是输出层。25 个神经元的那一列不是原始输入层。所以那个网络的最终输出是 $a^{[3]}$,咖啡豆网络的最终输出则是 $a ...
Hexo 公式渲染测试
这篇文章只使用 Typora 官方文档给出的两种写法:行内公式用单个美元符号,独立公式用单独成行的两个美元符号。 不使用图片或其他公式定界符,便于单独检查数学渲染。
在 Typora 中测试行内公式前,请先到「偏好设置 → Markdown → 数学公式」启用「行内公式(Inline Math)」,然后重启 Typora。独立公式与行内公式的开关不同,所以可能出现“独立公式正常、行内公式显示源码”的情况。
Hexo 是否显示数学公式,还取决于博客安装的数学渲染插件及主题配置;Typora 显示正常不代表 Hexo 一定正常。
1. 最简单的独立公式$$a+b=c$$
预期:上面单独显示一条排版后的公式,没有原始美元符号。
2. 分数与上下标$$J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)^2$$
预期:分数、求和号、上下标正常显示。这是线性回归的代价函数。
3. 行内公式这里的 $x$ 是输入,$w$ 是权重,$b$ 是偏置。线性回归的预测写成 $f_{w, ...
线性回归与逻辑回归:从损失函数到正则化
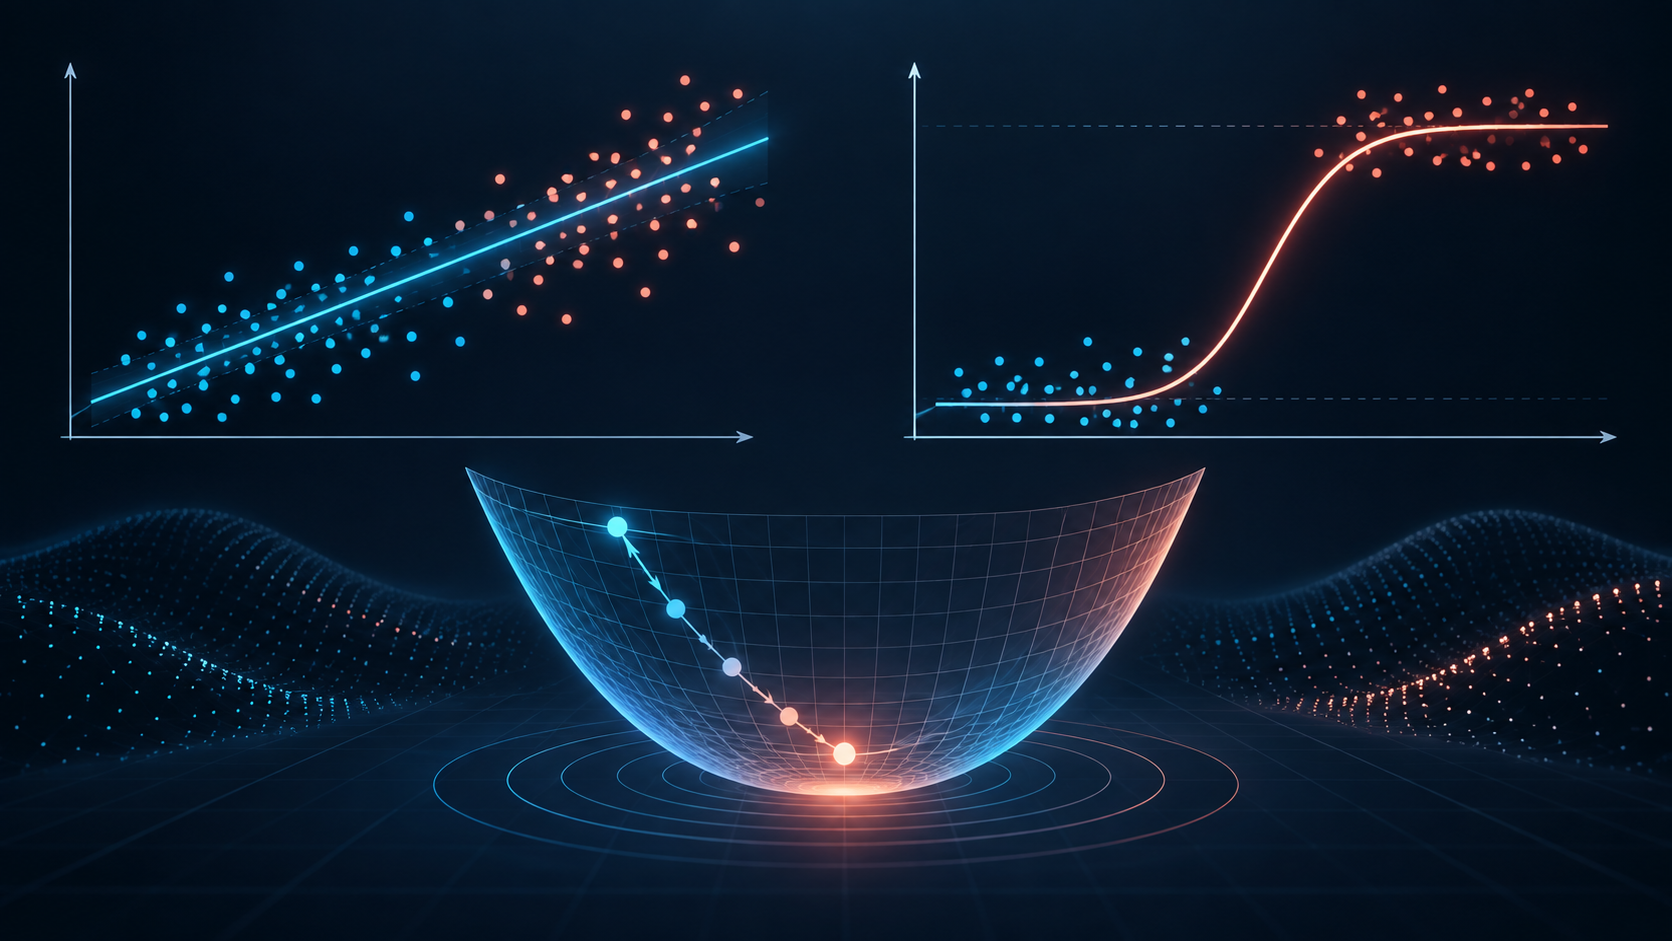
这篇笔记按吴恩达《机器学习专项课程》对应视频前 36 集的学习顺序整理:先认识线性回归及代价函数,再学习梯度下降、多特征与学习率,然后进入逻辑回归,最后讨论过拟合和正则化。该视频的第 37 集是访谈,第 38 集开始讲神经网络,因此本文停在线性回归和逻辑回归的正则化。文中也专门回答我之前容易混淆的几个问题:**z、e、f 到底是什么;f、单样本损失 L 和总体代价 J 有什么关系;为什么公式中有 1/2。**
记号约定:m 表示样本数,n 表示特征数;第 i 个样本的特征和真实值记为 x^(i)、y^(i);w 是特征权重,b 是偏置。图片中的上标 (i) 表示“第几个样本”,下标 j 表示“第几个特征”。
1. 线性回归:预测连续数值线性回归用来预测房价、温度、销量等连续数值。只有一个特征时,可以把模型看成一条直线:
这里的 x 是输入,w 决定斜率,b 决定整体上下平移,f 是模型给出的预测值。若同时用面积、房龄等多个特征,模型变成:
先用权重和偏置得到预测值,再比较它与真实值的距离,才能知道模型好不好。对一条样本,可用平方误差表示损失:
把所有 m 条样本的损失加起来并 ...

交叉验证与网格搜索:从原理到鸢尾花实战
学完 KNN 后,一个自然的问题是:邻居数量应该设为 3、5,还是其他值?某一次测试准确率高,就能说明这个参数好吗?
这篇文章从我学习时遇到的几个疑惑出发,梳理交叉验证与网格搜索的关系,再用鸢尾花数据集实现完整流程。
先记住两个分工:交叉验证负责评估一组参数,网格搜索负责尝试不同参数组合。
一、先分清三个概念
数据部分
作用
是否参与当轮模型训练
当轮训练集
拟合模型
是
当轮验证集
评价当前参数配置,辅助选参
否
独立测试集
选参结束后评估最终模型
否
本文采用“先留出测试集,再在训练部分内部做交叉验证”的流程:
123全部数据├── 训练部分 → 交叉验证与参数选择 → 使用全部训练部分重新训练└── 独立测试集 → 最后评估
交叉验证中的验证集,是从训练部分里轮流划出来的。它与最后保留的独立测试集不是同一回事。
二、5 折交叉验证,是把 20 条再细分吗?假设参与交叉验证的训练部分有 100 条数据,做 5 折交叉验证:
将这 100 条分为 5 份,每份 20 条。
每轮拿其中一份作为验证集。
剩余四份共 80 条作为当轮训练集。
一共做 5 轮, ...

KNN算法以及鸢尾花案例
KNN 是一个适合机器学习入门的算法:遇到一个未知样本,就在已知样本中找出与它最相似的几个,再根据这些邻居的答案做判断。
本文以鸢尾花分类为例,记录从加载数据、划分数据集,到标准化、训练、预测和评估的完整过程,并解释 fit()、predict() 和 score() 分别做了什么。
一、KNN 算法是什么?KNN 全称是 K-Nearest Neighbors,中文叫 K 近邻算法。K 表示参考的邻居数量。
本文讨论的是 KNN 分类:给定一条待预测样本,查找训练集中距离它最近的 K 条样本,根据这些邻居的类别投票。
例如 K=3,最近的三个邻居分别属于:
123邻居 A → 类别 1邻居 B → 类别 1邻居 C → 类别 2
采用每个邻居一票的规则时,类别 1 获得两票,因此预测结果是类别 1。
KNN 也可以用于回归,通常根据邻居的目标值求平均或加权平均;本文先关注分类。
1. 到底按什么排序?刚接触 KNN 时,一个容易出现的误解是:“是不是把每个特征分别升序排列?”
实际上,比较的是每条训练样本与待预测样本之间的距离,各个特征列不会被单独排序。 每条样本的全 ...

机器学习笔记
1.机器学习分类机器学习大致分为 监督学习,无监督学习两类
2.线性回归模型真实值 预测值在线性回归中,$f_{w,b}(x)$ 就是预测值 $\hat{y}$,两者表示相同的含义,即:
$$\hat{y}=f_{w,b}(x)=wx+b$$
其中,$x$ 是输入特征,$w$ 是权重或斜率,$b$ 是偏置或截距;$\hat{y}$ 表示模型计算出的预测值,$y$ 表示数据中的真实值。因此,模型的预测误差可以写成:
$$\hat{y}-y=f_{w,b}(x)-y$$
线性回归的目标是不断调整参数 $w$ 和 $b$,使预测值 $\hat{y}$ 尽可能接近真实值 $y$,从而减小代价函数 $J(w,b)$。
线性回归的代价函数 J(w,b)在线性回归中,模型的预测函数为:
$$f_{w,b}(x^{(i)})=wx^{(i)}+b$$
其中,$w$ 表示直线的斜率,$b$ 表示截距,$x^{(i)}$ 表示第 $i$ 个样本的输入,$y^{(i)}$ 表示该样本的真实值。
为了衡量模型预测值与真实值之间的差距,通常使用平方误差代价函数:
$$J ...

青少年数据集搜集
青少年数据集1.ChildGuard(多国:澳大利亚、阿联酋、印度、沙特、美国)针对儿童/青少年的仇恨言论数据集,包含351,877条标注实例,来自X(Twitter)、Reddit和YouTube,覆盖三个年龄段(13-17岁青少年、11-12岁前青少年、11岁以下儿童)。
ChildGuard是一个大型的、经过精心整理的数据集,包含超过35万条多语言社交媒体帖子,这些帖子均经过标注,专门针对儿童的仇恨言论,并配有详细的年龄段标签、上下文和词汇特征,以及严谨的专家标注,旨在支持对检测和减轻针对儿童的网络虐待的研究。
核心关注:针对儿童和青少年的仇恨言论,包括针对年龄、外貌、种族、国籍和残疾的攻击。包含情境子集(157K) 和词汇子集(194K) 两个子集。
ChildGuard包含351,877 个标注实例,这些实例收集自Reddit、X(原 Twitter)和YouTube。
论文地址:https://arxiv.org/abs/2506.21613数据集地址:https://github.com/gskgautam/ChildGuard
2.DeTox-Datase(德 ...
GR4AD论文总结
📝 GR4AD论文总结-详细版
## (2026-04-02) Generative Recommendation for Large-Scale Advertising
作者: Ben Xue; Dan Liu; Lixiang Wang; Mingjie Sun; Peng Wang; Pengfei Zhang; Shaoyun Shi; Tianyu Xu; Yunhao Sha; Zhiqiang Liu; et al.
期刊: (发表日期: 2026-04-02)
期刊分区:
本地链接: Xue 等 - 2026 - Generative Recommendation for Large-Scale Advertising.pdf
DOI: 10.48550/arXiv.2602.22732
摘要: Generative recommendation has recently attracted widespread attention in industry due to its potential for scaling ...

建立目标检测模型
设计网络模型概要输入: 图片Resize 448 * 448
输出:预测目标上的一个目标/物体
可以借助经典模型的部分框架
例如VGG16(经典模型,按照自己需求舍去图像分类部分)
利用前面的特征提取,舍去后面的分类
目标检测模型架构主干 — 颈部 — 头部
1. Backbone – 主干网络
核心作用:从输入图像中提取多尺度、多层次的特征。
工作方式:
像 CNN、ResNet、VGG、ViT 这类网络,会逐步下采样图像,生成不同分辨率的特征图。
浅层特征保留细节(如边缘、纹理),深层特征保留语义(如物体类别、整体结构)。
类比:相当于人的视觉皮层,先把看到的画面拆解成各种基础视觉元素。
2. Neck – 颈部网络
核心作用:对 Backbone 输出的多尺度特征进行融合与增强,实现多分辨率特征聚合。
工作方式:
常见结构如 FPN、PANet、BiFPN,通过上采样 + 下采样的路径,让不同层级的特征互相传递信息。
解决 “小物体特征太弱、大物体特征太粗” 的问题,让每个尺度的特征都包含丰富的上下文信息。
类比:相当于人的视觉中枢,把零散 ...
YOLO11 目标检测
YOLO算法
YOLO11 网络结构图
YOLO11 中的 CBS 模块YOLO11 里的 CBS 是核心基础模块,是构成整个网络的「最小单元」,你可以把它理解成 YOLO 系列里 Conv-BN-SiLU 的「三合一封装」。
一、CBS 的全称 & 组成(拆解开就懂)CBS = Conv(卷积层) + BN(批量归一化) + SiLU(激活函数)
(注:早期 YOLO 版本用 LeakyReLU,YOLOv8/11 统一换成 SiLU,也叫 Swish 激活)
表格
组件
作用
Conv 卷积层
提取特征、调整通道数(比如把 3 通道图片转成 64 通道特征图)
BN 批量归一化
加速训练、防止过拟合、稳定梯度(不用手动调学习率,训练更快)
SiLU 激活函数
引入非线性,让网络能拟合复杂特征(比 ReLU 更平滑,精度更高)
二、CBS 在 YOLO11 里的作用
特征提取的「第一步」:输入图片后,第一个模块就是 CBS,先把原始图片转成高维特征图;
轻量化设计:YOLO11 用 CBS 替代了早期复杂的卷积组合,减少参数和 ...