线性回归与逻辑回归:从损失函数到正则化
这篇笔记按吴恩达《机器学习专项课程》对应视频前 36 集的学习顺序整理:先认识线性回归及代价函数,再学习梯度下降、多特征与学习率,然后进入逻辑回归,最后讨论过拟合和正则化。该视频的第 37 集是访谈,第 38 集开始讲神经网络,因此本文停在线性回归和逻辑回归的正则化。文中也专门回答我之前容易混淆的几个问题:**z、e、f 到底是什么;f、单样本损失 L 和总体代价 J 有什么关系;为什么公式中有 1/2。**
记号约定:
m表示样本数,n表示特征数;第i个样本的特征和真实值记为x^(i)、y^(i);w是特征权重,b是偏置。图片中的上标(i)表示“第几个样本”,下标j表示“第几个特征”。
1. 线性回归:预测连续数值
线性回归用来预测房价、温度、销量等连续数值。只有一个特征时,可以把模型看成一条直线:
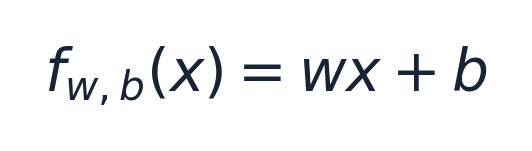
这里的 x 是输入,w 决定斜率,b 决定整体上下平移,f 是模型给出的预测值。若同时用面积、房龄等多个特征,模型变成:
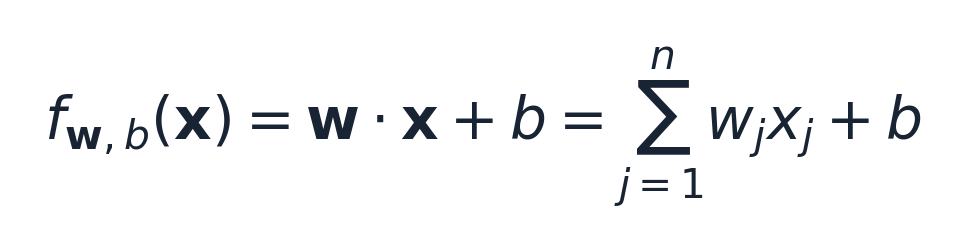
先用权重和偏置得到预测值,再比较它与真实值的距离,才能知道模型好不好。对一条样本,可用平方误差表示损失:
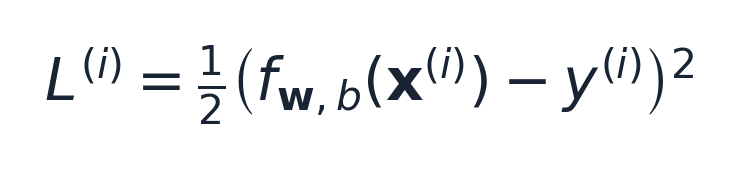
把所有 m 条样本的损失加起来并取平均,就得到训练时要尽量降低的代价函数:
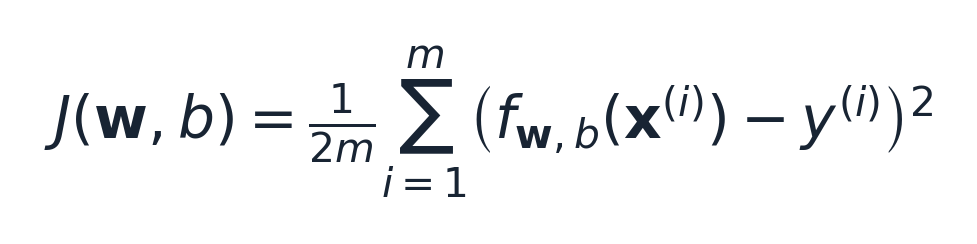
f 是预测,L 是一条样本的错误程度,J 是整批训练样本的平均错误程度。平方会让较大的误差受到更重的惩罚。公式中的 1/2 是为了求导时抵消平方项带来的系数 2;它只是方便计算,不会改变使代价最小的参数位置。多除以 m 则是为了取平均,避免样本数量变化时数值尺度跟着变化。
2. 梯度下降:怎样找到更合适的参数
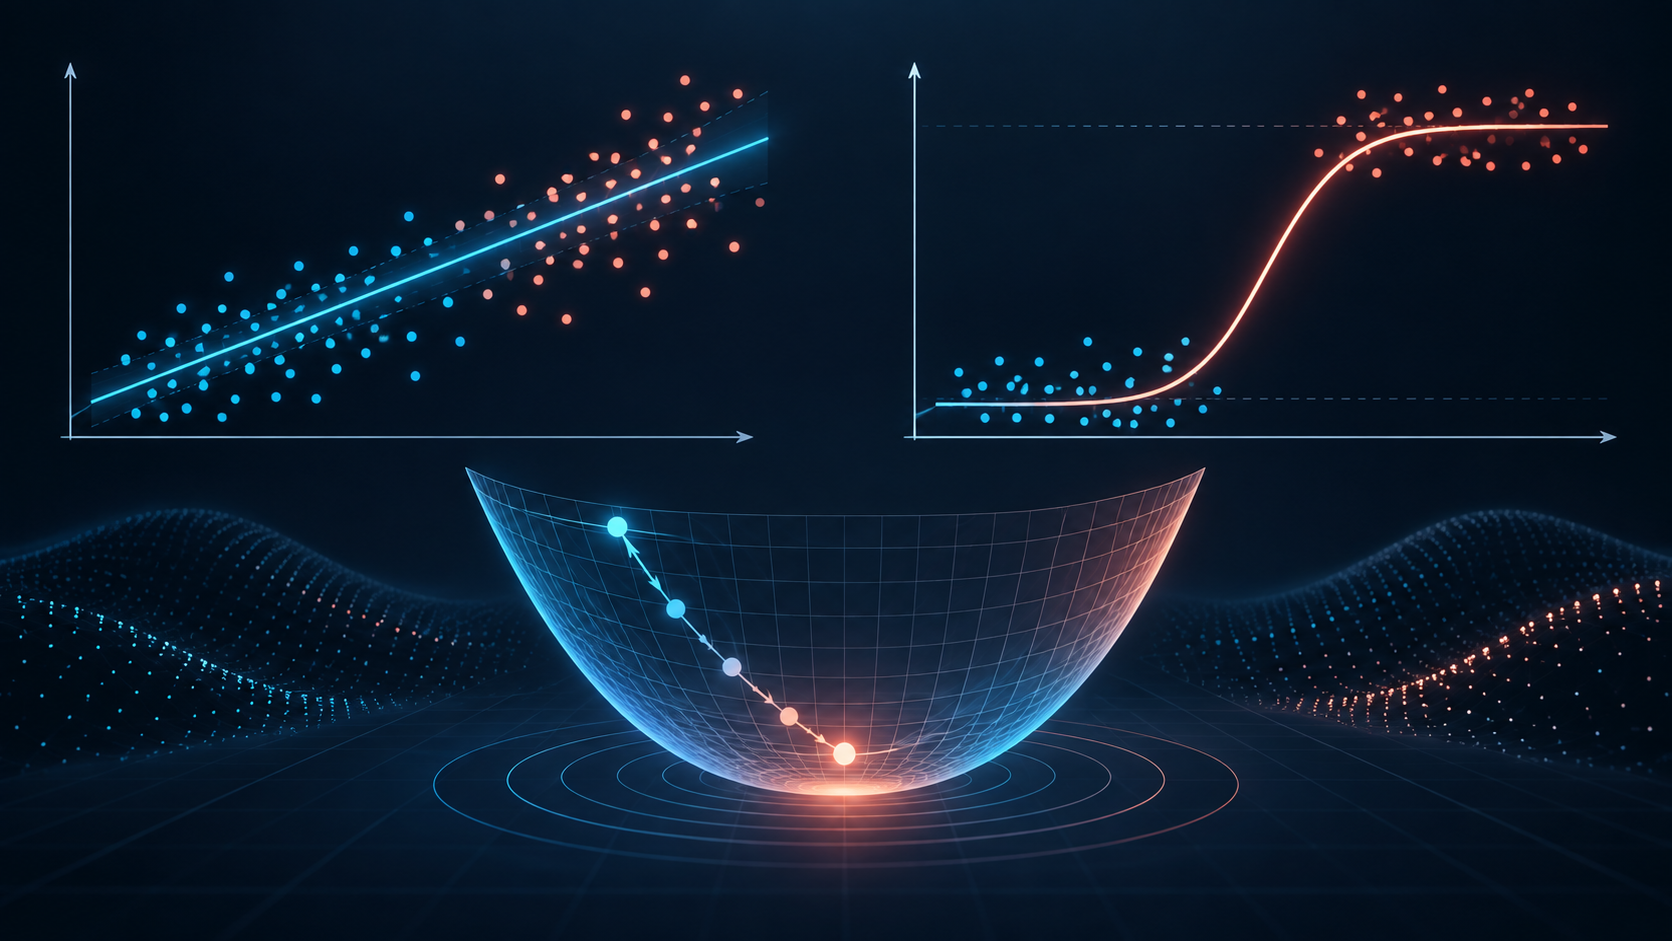
代价函数告诉我们当前参数的表现,梯度下降负责调整 w 和 b。可以想象自己站在山坡上:梯度指出局部上升最快的方向,沿它的反方向走,代价通常会降低。
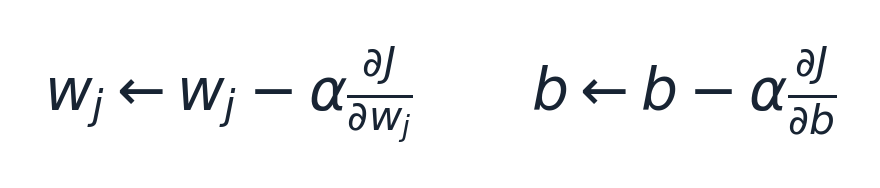
α(alpha)是学习率,控制每一步走多远。线性回归的两个梯度分别是:
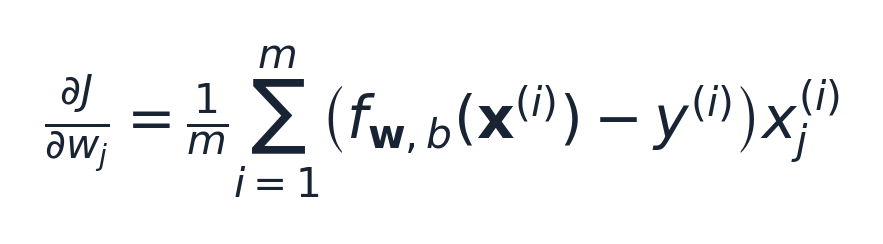
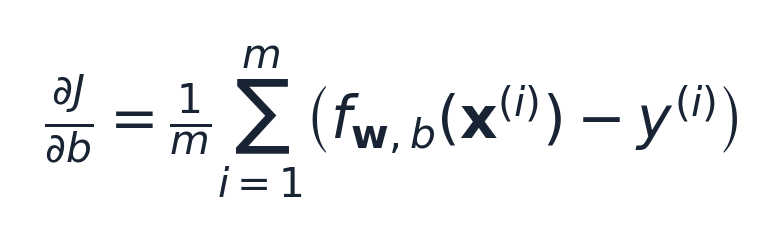
训练时先用旧的 w、b 算出所有梯度,再同时更新参数。如果先更新 w,再拿新 w 去计算 b 的梯度,就不是这一步原本的同步更新了。
学习率怎样选
- 太小:每次只移动一点,代价下降很慢。
- 太大:可能来回跳过最低点,甚至使代价越来越大。
- 合适:代价总体上逐步下降,并最终趋于平稳。
可以记录每轮的 J 并画成曲线:稳定下降说明方向大体正常;持续增大或剧烈振荡时,先检查公式和实现,再尝试减小学习率。这里的 α 控制优化步长,后面正则化的 λ 控制惩罚强度;两者作用不同。
多特征时为什么常做特征缩放
如果面积的数值是几千、房间数只有个位数,不同特征的尺度差别很大,梯度下降可能走得很曲折。常见做法是将每一列特征标准化:
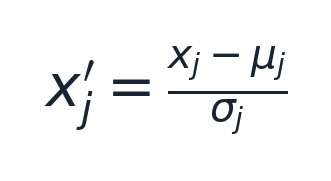
μ 是该特征在训练集上的均值,σ 是训练集上的标准差。验证集和测试集必须沿用训练集算出的均值与标准差,不能各自重新计算。特征缩放主要帮助优化过程;它本身不是解决过拟合的正则化。
3. 逻辑回归:预测二分类概率
逻辑回归虽然名字带“回归”,在这里解决的是二分类问题,例如是否患病、邮件是否为垃圾邮件。输出希望落在 0 到 1 之间,便于解释为属于正类(y=1)的概率。
第一步,像线性模型那样,把特征加权求和:
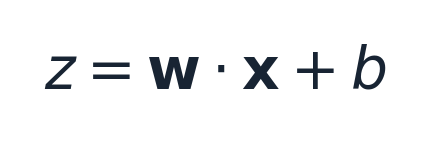
这个结果叫 z,可以取任意实数。第二步,把 z 送入 sigmoid 函数:
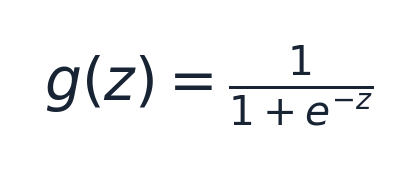
这里的 e 是数学常数,约为 2.71828;e 的 -z 次方只是 sigmoid 公式的一部分,不是误差,也不是另一个待训练参数。把两步连起来,得到逻辑回归的预测函数:
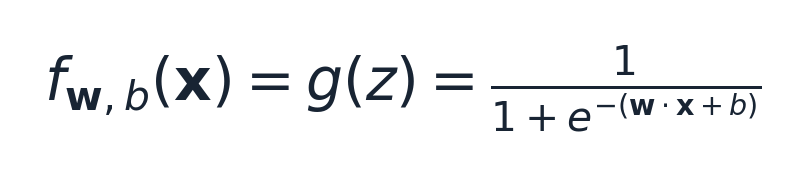
从左到右记:输入 x → 算出 z → 经过 sigmoid → 得到 f。例如 z=0 时,f=0.5;z=2 时,f≈0.881;z=-2 时,f≈0.119。通常以 0.5 为阈值:f≥0.5 判为正类,否则判为负类。因为 sigmoid 在 z=0 时输出 0.5,所以决策边界对应 z=0;若使用多项式特征,边界在原始特征空间中也可以是曲线。
4. 逻辑回归的损失函数
逻辑回归的 f 是概率,不宜直接沿用线性回归的平方误差作为课程中的训练目标。这里使用对数损失:
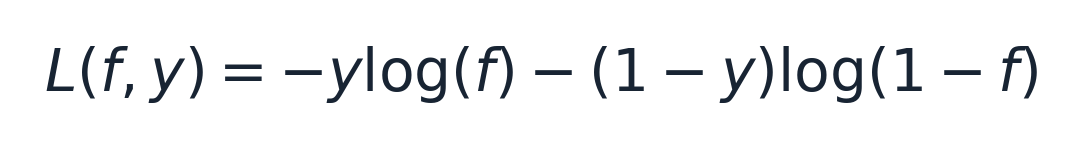
这一个式子同时包含两种情况:
| 真实标签 | 单样本损失会变成 | 直观含义 |
|---|---|---|
y=1 |
-log(f) |
f 越接近 1,损失越小;若非常确信是 0,损失很大 |
y=0 |
-log(1-f) |
f 越接近 0,损失越小;若非常确信是 1,损失很大 |
这两行是按 y 的取值拆开看同一个公式,并不是两个互相补充、需要同时相加的新公式。例如真实值为 1 时,预测 f=0.9 的损失约为 0.105,预测 f=0.1 的损失约为 2.303。模型越自信地预测错,受到的惩罚越大。
对全部样本取平均,得到逻辑回归的总体代价:
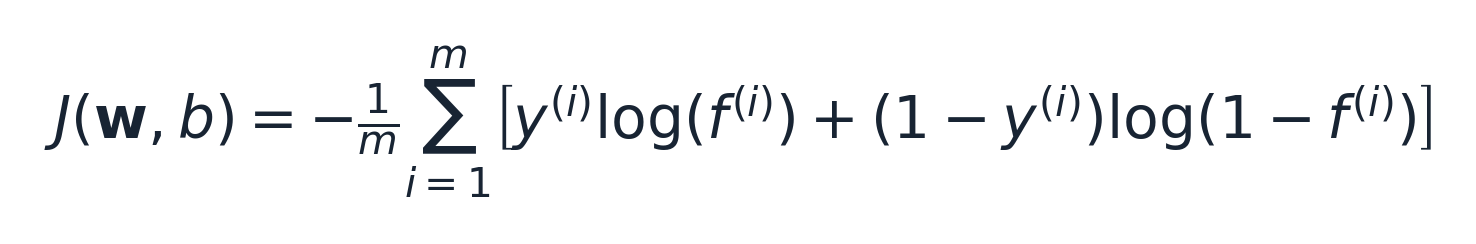
此处 f^(i) 表示第 i 条样本经过 sigmoid 后的预测概率。再次区分:**z 是加权和,f 是预测概率,L 是一条样本的损失,J 是全体样本的平均代价。**
5. 逻辑回归也用梯度下降
逻辑回归仍然使用第 2 节的梯度下降更新规则,只是换成对数损失来计算梯度。整理后的梯度形式如下:
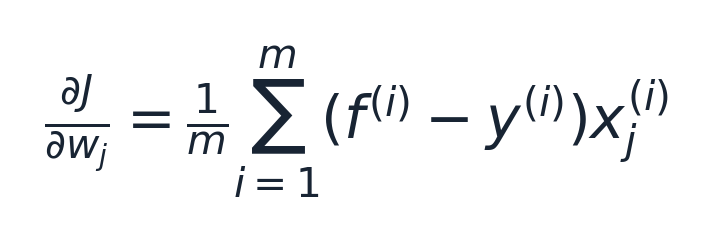
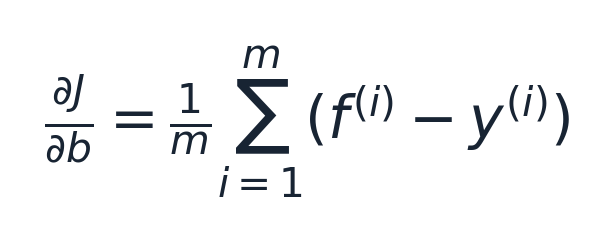
你会发现它们与线性回归的梯度形式很像,但 f 的定义不同:线性回归的 f 直接是加权和;逻辑回归的 f 是加权和再经过 sigmoid 的结果。因此不能说两种模型或两种损失函数相同。
6. 过拟合:训练集答得好,不代表新数据答得好
模型过于简单,连训练数据的主要趋势都学不到,叫欠拟合。模型过于复杂,把训练数据中的噪声也当作规律,训练集上表现很好、换一批数据却变差,叫过拟合。线性回归用很高次数的多项式、逻辑回归用过多复杂特征时,都可能遇到它。
课程给出的主要思路是:增加训练数据、减少或选择特征,以及使用正则化。正则化的意思是在原来的代价后面加一项,抑制权重变得过大。课程这里主要使用 L2 正则化:
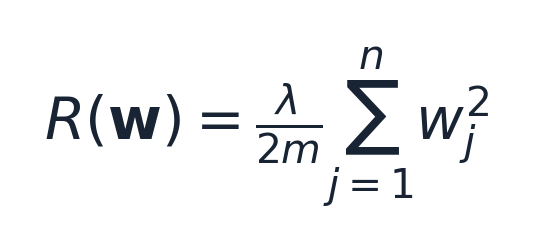
λ(lambda)越大,对大权重的惩罚越强;λ=0 时就没有正则化。通常**不惩罚偏置 b**,所以求和从 w1 到 wn,不包含 b。正则化不是保证永不过拟合:λ 太大可能让模型过于简单,转而欠拟合。
正则化线性回归
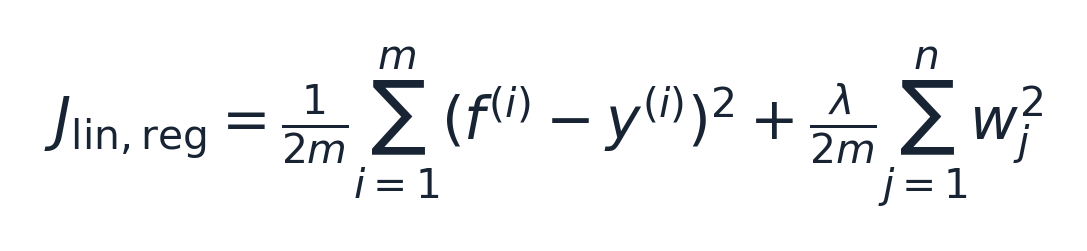
正则化逻辑回归
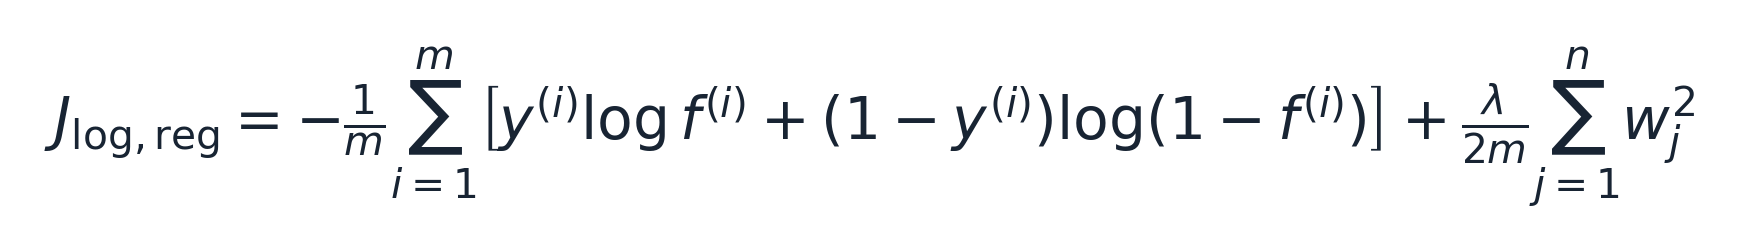
两种模型的原始损失不同,但加入的是同样的权重平方惩罚。加入正则化后,对每个权重的梯度多出一项:
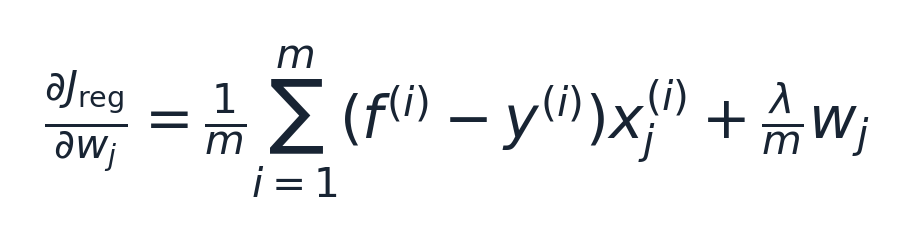
因此权重更新为:
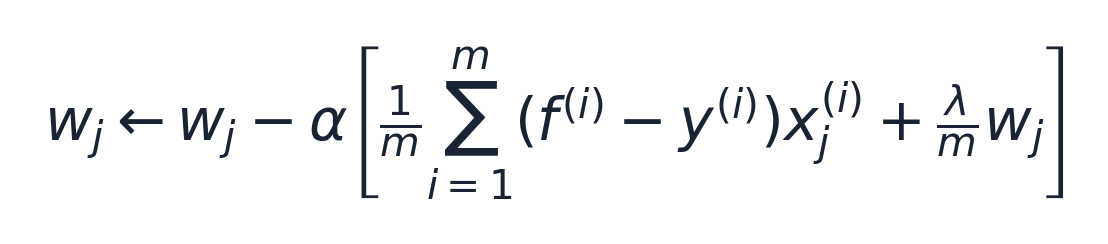
其中 f 取各自模型的预测函数。b 的梯度不加正则化项。可以把 λ 理解为“不让模型过度依赖某些大权重”的力度;把 α 理解为“每次更新走多远”的步长。
7. 一张表串起来
| 问题 | 线性回归 | 逻辑回归 |
|---|---|---|
| 任务 | 预测连续数值 | 预测二分类概率 |
预测函数 f |
特征加权和 | 特征加权和经过 sigmoid |
| 单样本损失 | 平方误差 | 对数损失 |
总体代价 J |
平均平方误差 | 平均对数损失 |
| 参数优化 | 梯度下降 | 梯度下降 |
| 控制过拟合 | 可添加 L2 正则化 | 可添加 L2 正则化 |
记忆主线:选模型得到 f → 用损失衡量预测错误 → 对全部样本求平均得到 J → 用梯度下降最小化 J → 用学习率控制步长 → 必要时用正则化限制模型复杂度。