TensorFlow 前向传播详解:从咖啡豆案例到多层神经网络
神经网络如何把“温度和烘焙时间”变成一个预测概率?Dense(3) 为什么输出三个数?课程里的 $a_j^{[\ell]}$,右上角和右下角分别表示什么?
这篇笔记从咖啡豆烘焙案例出发,逐个神经元展开计算,再对应到 TensorFlow 代码,最后推广到课程中的手写数字识别网络。
1. 先看清网络:输入层与计算层
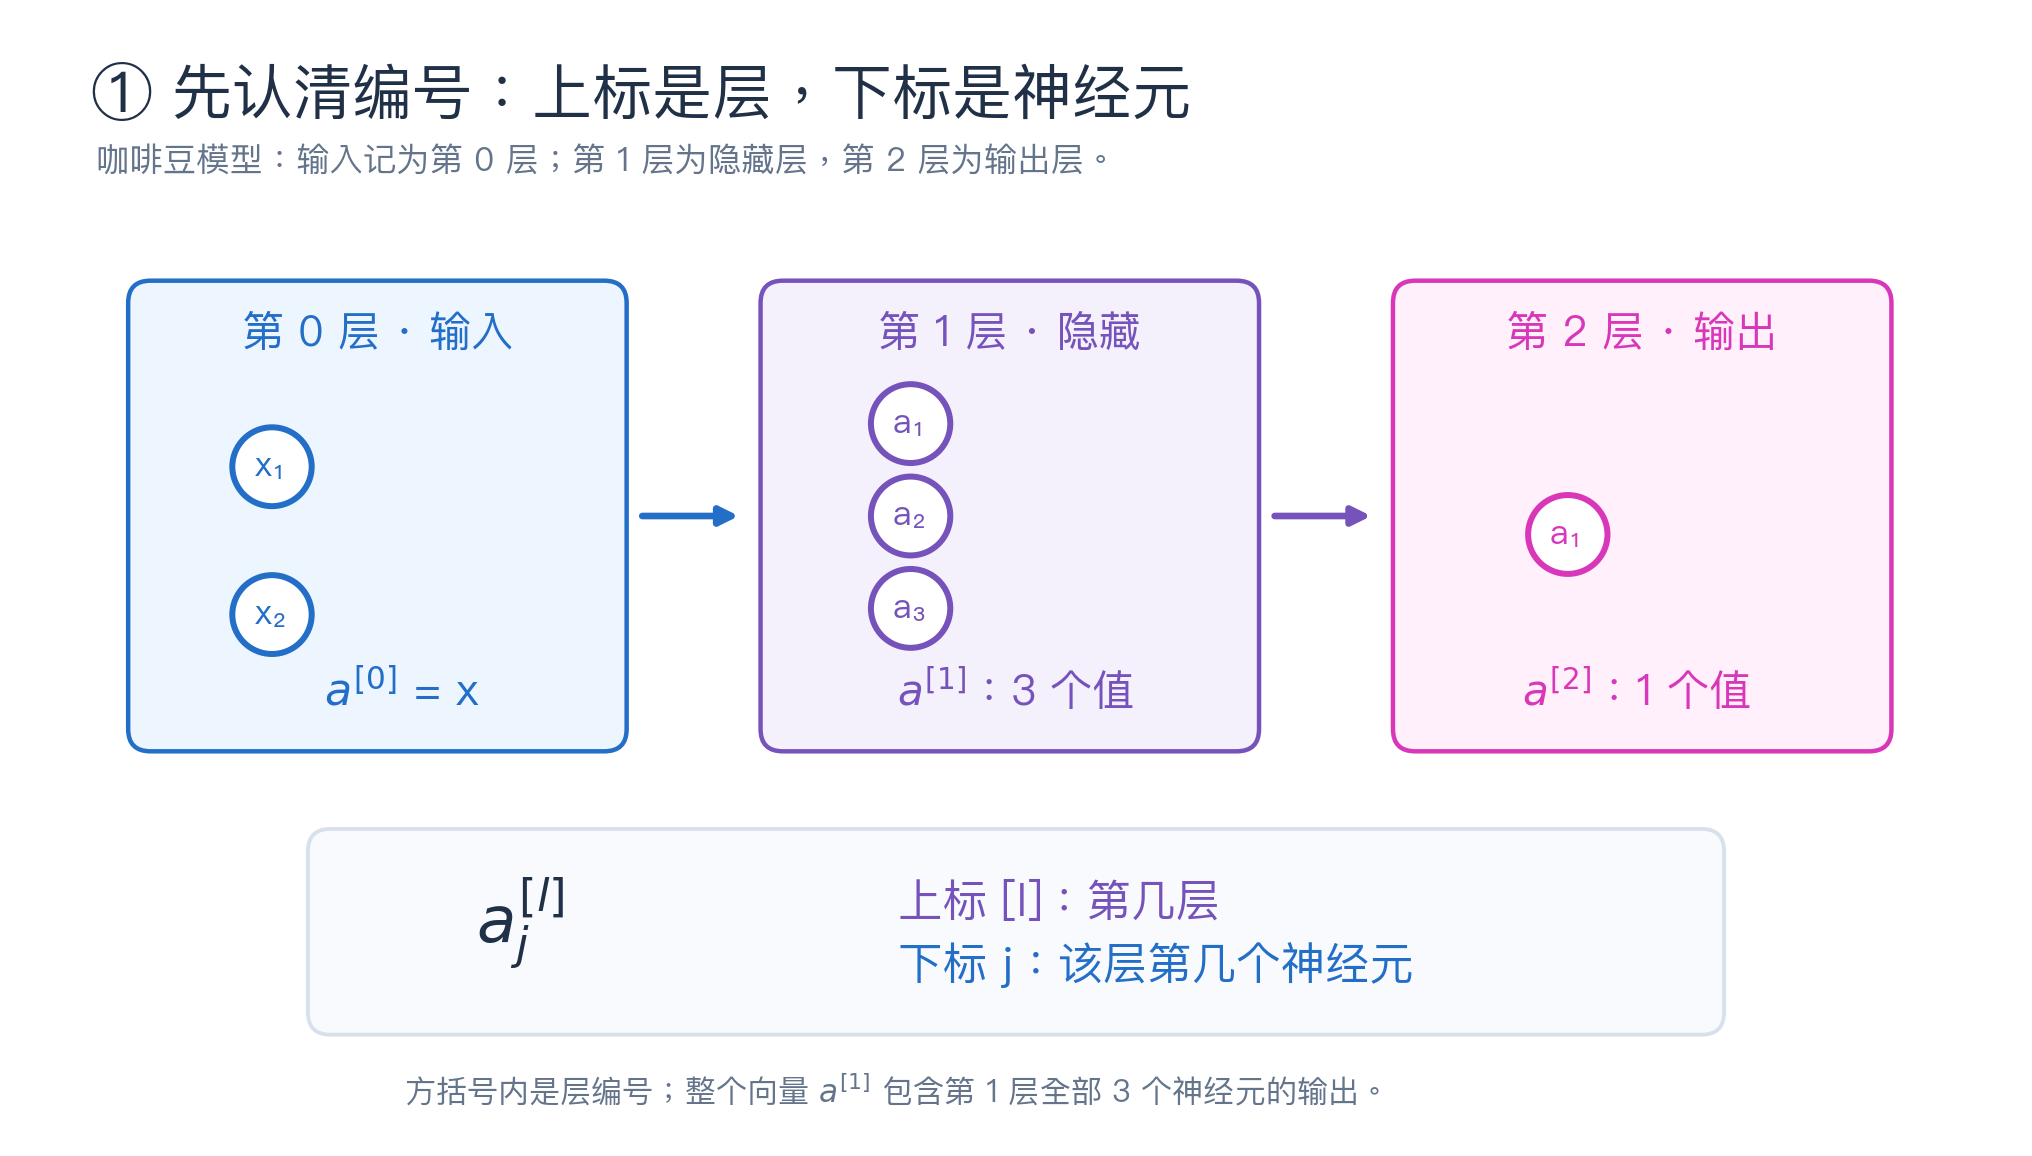
咖啡豆案例有两个输入特征:温度与烘焙时间。示例网络包含一个有 3 个神经元的隐藏层,以及一个有 1 个神经元的输出层。
本文统一采用以下编号:
- 输入记为第 0 层,$a^{[0]}=x$。
- 第 1 层是隐藏层,输出为 $a^{[1]}$。
- 第 2 层是输出层,输出为 $a^{[2]}$。
因此,咖啡豆网络有 2 个参与学习的 Dense 层。输入负责提供数据,没有这一类权重与偏置。
课程手写数字截图需要特别看清:从 $x$ 后面开始,25 个神经元是第 1 个隐藏层,15 个神经元是第 2 个隐藏层,最后 1 个神经元是第 3 层,也就是输出层。25 个神经元的那一列不是原始输入层。所以那个网络的最终输出是 $a^{[3]}$,咖啡豆网络的最终输出则是 $a^{[2]}$。
2. 读懂 a 的上标、下标与向量
神经元的输出通常写成:
$$
a_j^{[\ell]}
$$
$a$ 表示 activation,即激活值;$[\ell]$ 表示第几层,$j$ 表示该层第几个神经元。方括号是编号的一部分,不表示乘方。
| 符号 | 含义 |
|---|---|
| a1[1] | 第 1 层第 1 个神经元的激活值 |
| a2[1] | 第 1 层第 2 个神经元的激活值 |
| a3[1] | 第 1 层第 3 个神经元的激活值 |
| a[1] | 第 1 层所有激活值组成的向量 |
| a1[2] | 第 2 层第 1 个神经元的激活值 |
咖啡豆网络的第 1 层有三个神经元:
$$
a^{[1]}=
\begin{bmatrix}
a_1^{[1]} & a_2^{[1]} & a_3^{[1]}
\end{bmatrix}
$$
输出层只有一个神经元:
$$
a^{[2]}=
\begin{bmatrix}
a_1^{[2]}
\end{bmatrix}
$$
$a_1^{[2]}$ 是标量;$a^{[2]}$ 是包含这个标量的向量。TensorFlow 还保留样本数量这一维,所以一条样本的最终结果通常是 [[0.60075]],形状为 (1, 1)。
课程有时在 $a$ 上面加箭头表示向量;本文写 $a^{[\ell]}$ 时表示整层向量,带下标的 $a_j^{[\ell]}$ 表示其中一个分量。
3. 一个神经元做两步计算
第一步是对输入加权求和,再加上偏置:
$$
z_j^{[\ell]}
=\sum_{k=1}^{n_{\ell-1}}
a_k^{[\ell-1]}w_{kj}^{[\ell]}+b_j^{[\ell]}
$$
第二步是把结果送进激活函数:
$$
a_j^{[\ell]}=g^{[\ell]}\left(z_j^{[\ell]}\right)
$$
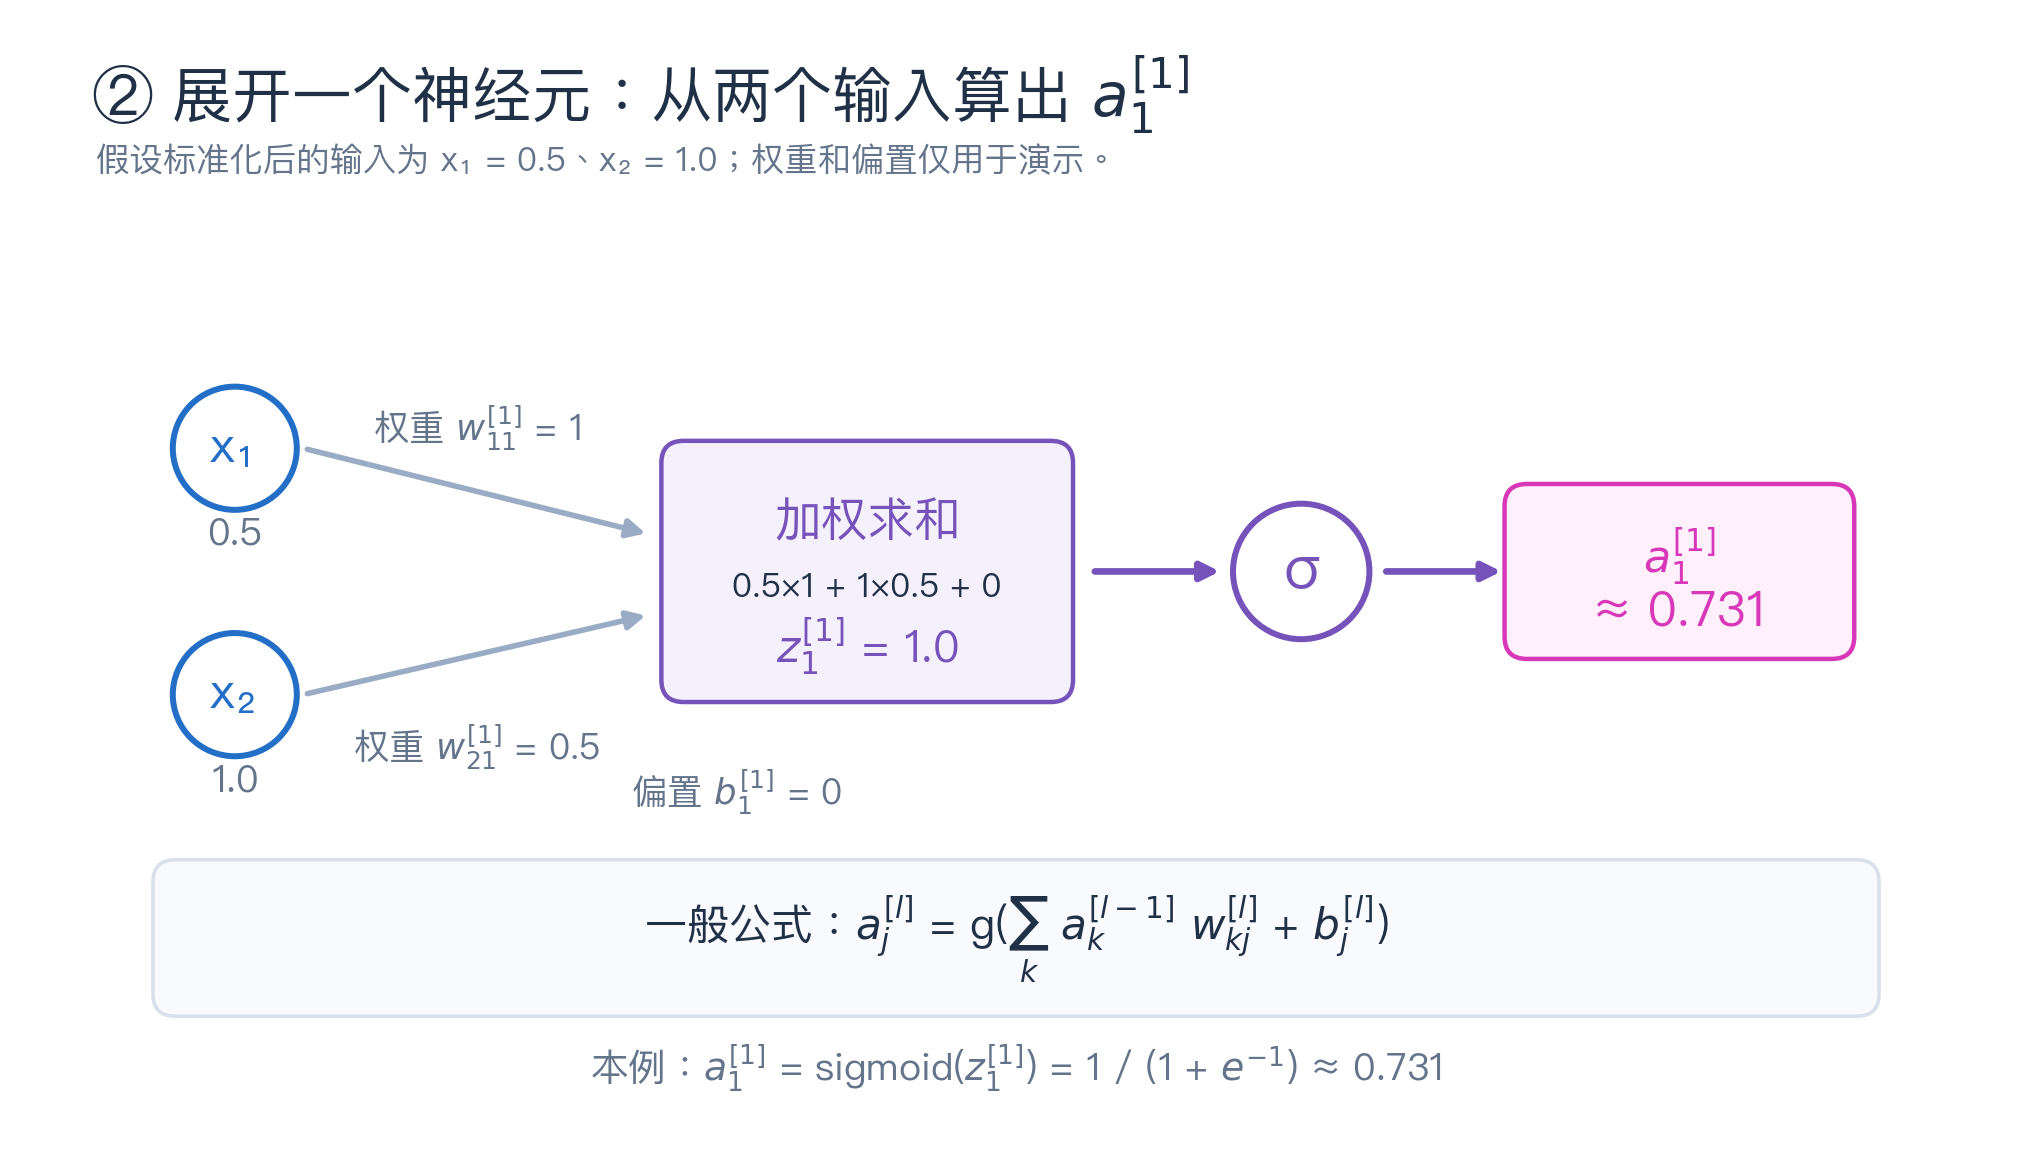
$n_{\ell-1}$ 是上一层的输出数量。$w_{kj}^{[\ell]}$ 表示“上一层第 $k$ 个输出到当前层第 $j$ 个神经元”的连接权重,$b_j^{[\ell]}$ 是当前神经元的偏置。
为了对应 TensorFlow 的矩阵布局,本文把权重的两个下标写成“输入编号、输出神经元编号”。其他教材可能使用相反的矩阵布局,比较公式时要先确认下标约定。
课程常把同一公式写成权重向量与输入向量的点积:
$$
a_j^{[\ell]}
=g^{[\ell]}\left(
\mathbf{w}_j^{[\ell]}\cdot
\mathbf{a}^{[\ell-1]}+b_j^{[\ell]}
\right)
$$
$\mathbf{w}_j^{[\ell]}$ 是第 $j$ 个神经元的全部输入权重,长度等于上一层的输出数量。
本例使用 sigmoid:
$$
\sigma(z)=\frac{1}{1+e^{-z}}
$$
它把有限实数映射到 0 与 1 之间。隐藏层的激活值虽然也在这个区间,但不能直接把每一个都解释成最终分类概率。
4. 用具体数字算完三个隐藏神经元
4.1 约定输入
原始样本是温度 200、时间 17。为了方便手算,假设预处理使用的温度均值与标准差分别是 190、20,时间均值与标准差分别是 15、2,那么:
$$
x_1=\frac{200-190}{20}=0.5,
\qquad
x_2=\frac{17-15}{2}=1
$$
因此本节输入为:
$$
x=a^{[0]}=
\begin{bmatrix}
0.5 & 1
\end{bmatrix}
$$
以上均值、标准差,以及下面的权重和偏置,都是为讲解而设定的数值。实际项目中的标准化参数应从训练集估计,模型权重由训练学习。仅仅输入 [200, 17] 并不能决定输出一定是某个固定数字。
4.2 三个神经元使用不同的参数
| 隐藏神经元 | 温度权重 | 时间权重 | 偏置 |
|---|---|---|---|
| 第 1 个 | 1 | 0.5 | 0 |
| 第 2 个 | 0 | 1 | -0.5 |
| 第 3 个 | -1 | 0.5 | 0 |
第 1 个神经元:
$$
z_1^{[1]}=0.5\times1+1\times0.5+0=1
$$
$$
a_1^{[1]}=\sigma(1)\approx0.731059
$$
第 2 个神经元:
$$
z_2^{[1]}=0.5\times0+1\times1-0.5=0.5
$$
$$
a_2^{[1]}=\sigma(0.5)\approx0.622459
$$
第 3 个神经元:
$$
z_3^{[1]}=0.5\times(-1)+1\times0.5+0=0
$$
$$
a_3^{[1]}=\sigma(0)=0.5
$$
把三个结果放在一起,就是第 1 层的激活向量:
$$
a^{[1]}\approx
\begin{bmatrix}
0.731059 & 0.622459 & 0.5
\end{bmatrix}
$$
三个神经元都接收温度和时间。Dense 中的“全连接”指上一层的每个输出都连接到当前层的每个神经元;不同连接使用各自的权重。
5. 整层计算:TensorFlow 为什么要用矩阵
把三个神经元的权重按列排列:
$$
W^{[1]}=
\begin{bmatrix}
1 & 0 & -1\
0.5 & 1 & 0.5
\end{bmatrix},
\qquad
b^{[1]}=
\begin{bmatrix}
0 & -0.5 & 0
\end{bmatrix}
$$
第 1 列对应第 1 个神经元,第 2 列对应第 2 个神经元,第 3 列对应第 3 个神经元。
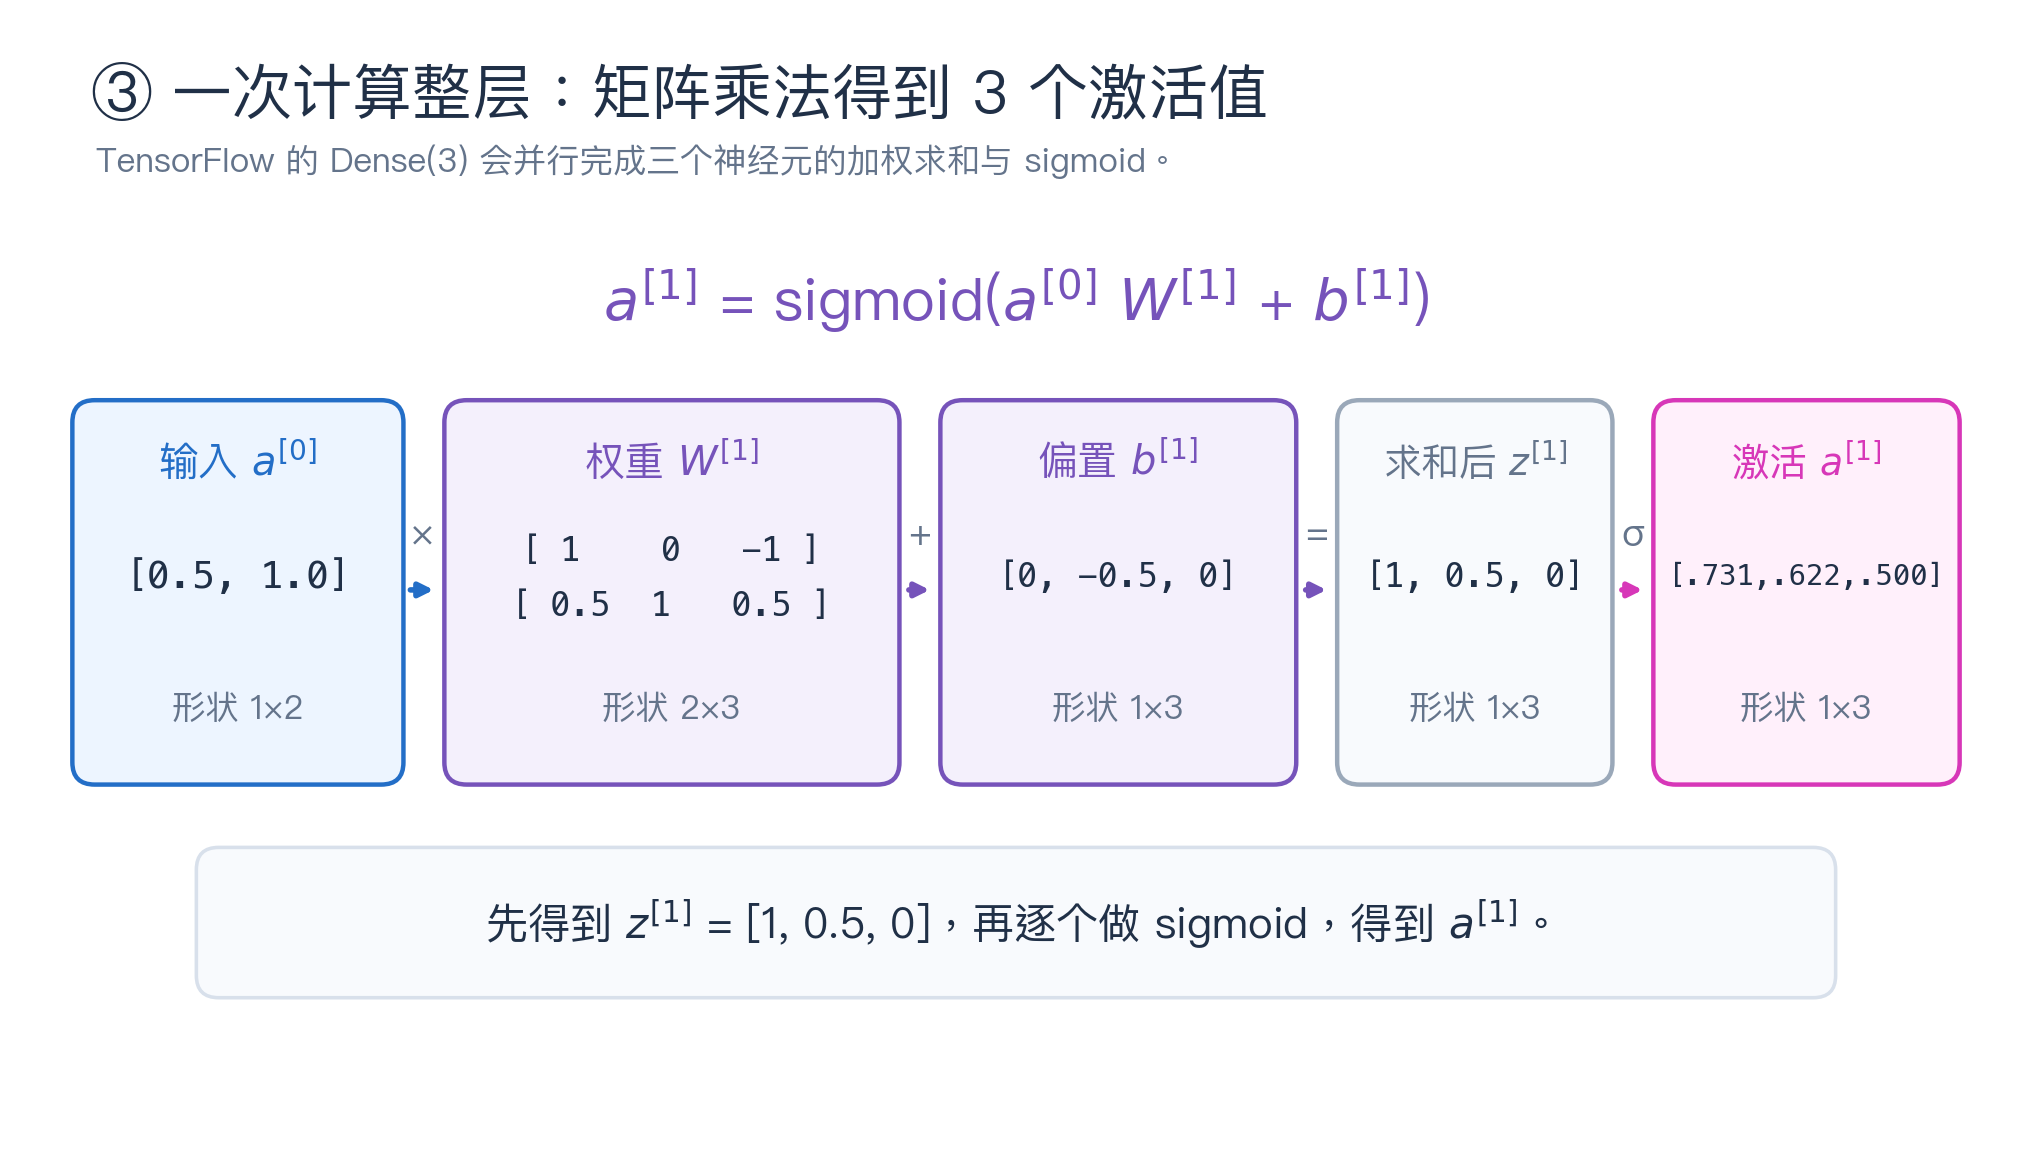
采用与 TensorFlow 一致的“样本按行排列”约定,整层公式为:
$$
z^{[1]}=a^{[0]}W^{[1]}+b^{[1]}
$$
$$
a^{[1]}=\sigma\left(z^{[1]}\right)
$$
代入数值:
$$
\begin{bmatrix}0.5 & 1\end{bmatrix}
\begin{bmatrix}1 & 0 & -1\0.5 & 1 & 0.5\end{bmatrix}
+
\begin{bmatrix}0 & -0.5 & 0\end{bmatrix}
\begin{bmatrix}1 & 0.5 & 0\end{bmatrix}
$$
再对三个元素分别应用 sigmoid,就得到前一节的三个激活值。矩阵运算把同样的计算集中起来,避免在 Python 中逐个神经元循环。
形状变化为:
$$
(1\times2)(2\times3)+(1\times3)
\longrightarrow(1\times3)
$$
真实 Keras 层中的偏置保存为形状 (3,) 的向量,并通过广播加到每一条样本上。图中写成 $1\times3$,是为了展示行向量加法。
6. 输出层:从三个激活值到一个概率
假设输出层权重与偏置为:
$$
W^{[2]}=
\begin{bmatrix}1\-1\1\end{bmatrix},
\qquad
b_1^{[2]}=-0.2
$$
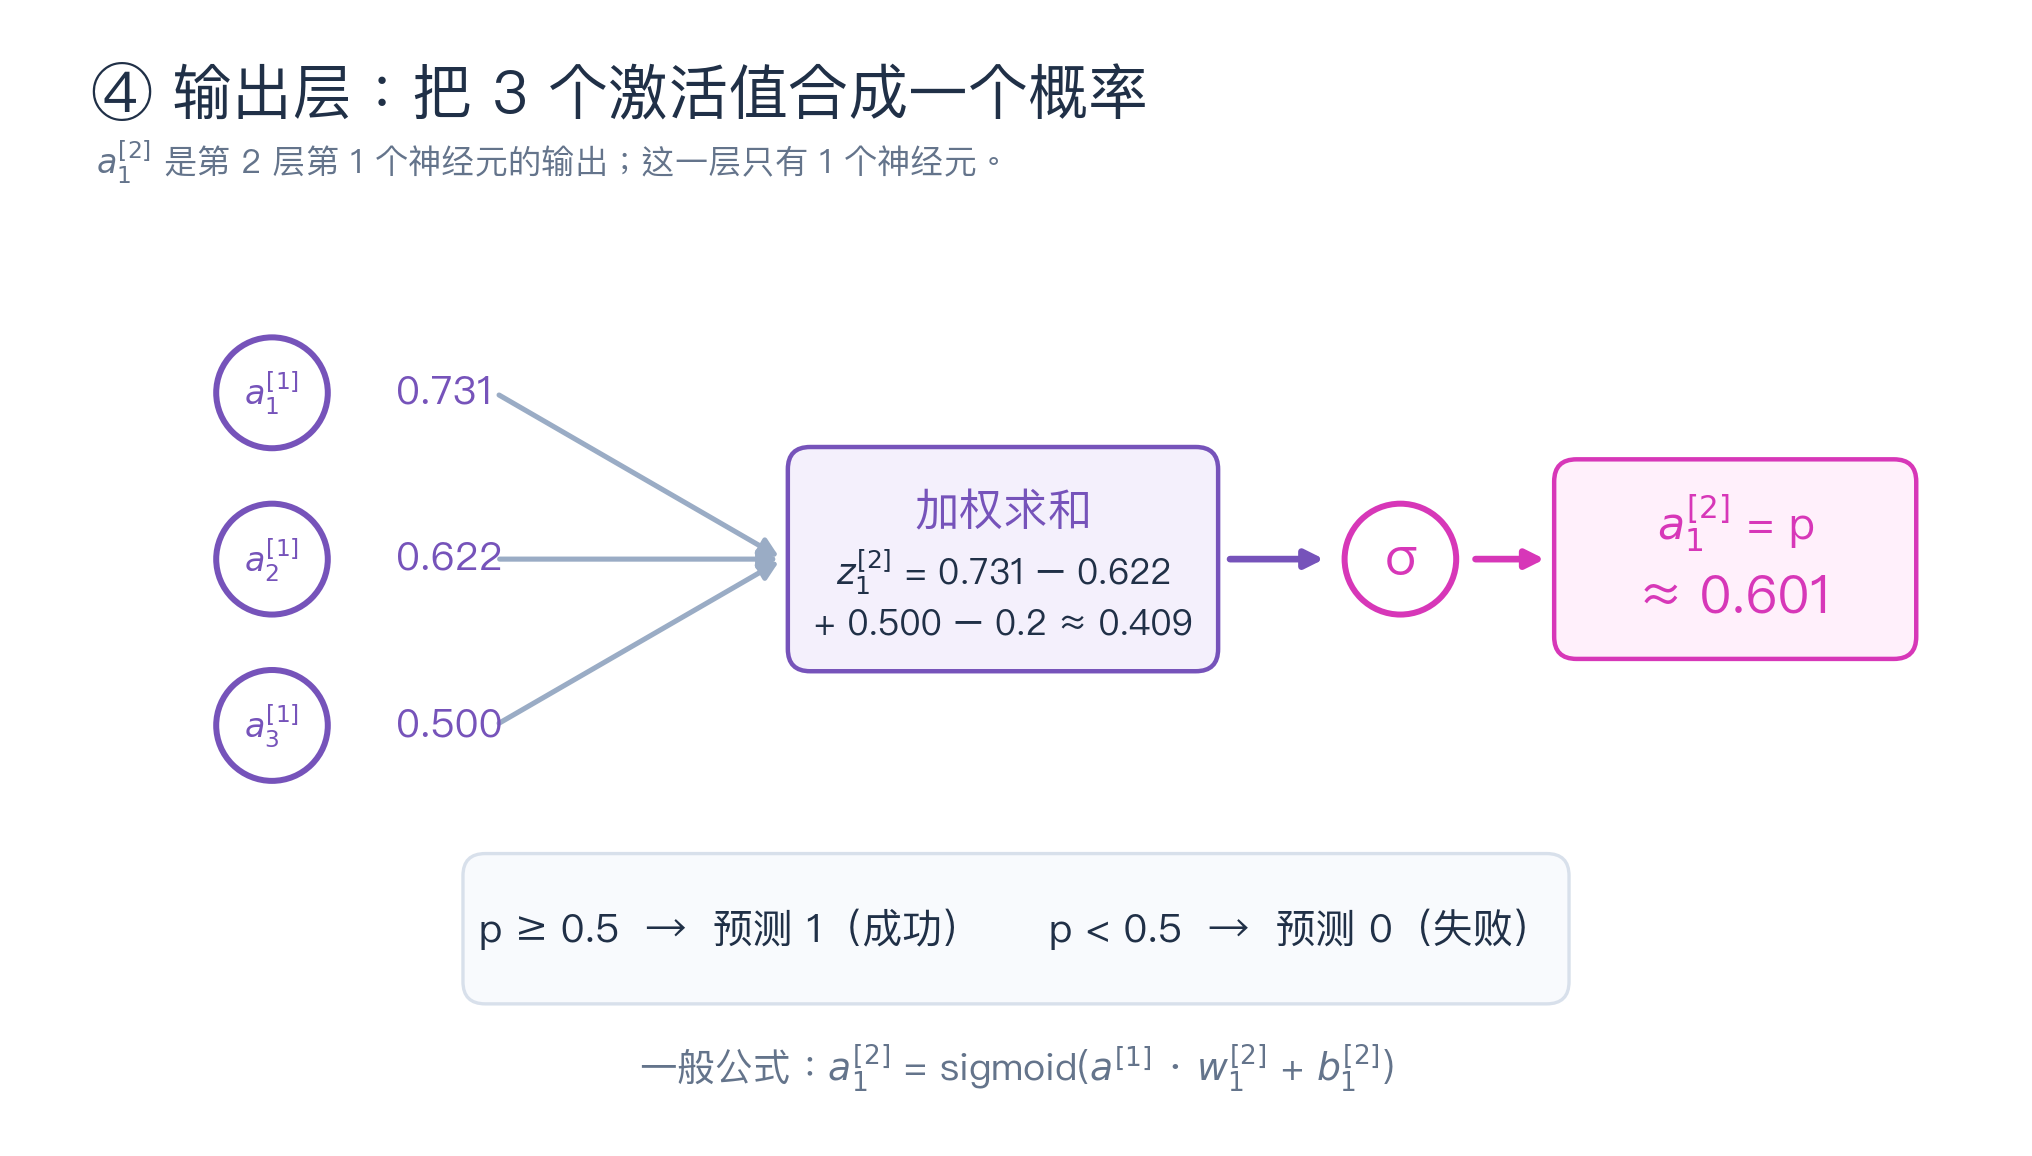
先做加权求和:
$$
z_1^{[2]}
=a_1^{[1]}\times1
+a_2^{[1]}\times(-1)
+a_3^{[1]}\times1-0.2
$$
$$
z_1^{[2]}
\approx0.731059-0.622459+0.5-0.2
=0.408599
$$
再经过 sigmoid:
$$
p=a_1^{[2]}=\sigma(0.408599)\approx0.600752
$$
在用标签 0/1 和二分类损失训练的模型中,这个输出被用作“属于类别 1”的预测概率。这里约定 1 表示烘焙成功:
$$
\hat y=
\begin{cases}
1,&p\ge0.5\
0,&p<0.5
\end{cases}
$$
因此演示样本被判为 1。$0.5$ 是本例选用的阈值,实际任务可以根据误报、漏报的代价调整。
神经网络的概率输出和阈值判断是两个步骤。model.predict() 返回模型输出,不会自动把概率转成 0 或 1。
7. 为什么需要激活函数
如果两层之间不加非线性激活函数,那么:
$$
(xW^{[1]}+b^{[1]})W^{[2]}+b^{[2]}
=x(W^{[1]}W^{[2]})+
(b^{[1]}W^{[2]}+b^{[2]})
$$
它仍然能合并成一次线性变换加偏置。增加这样的层并不会自动得到更复杂的非线性关系。
sigmoid 等非线性激活函数让多层网络能够组合出更复杂的关系。本例按照课程入门案例,两层都使用 sigmoid;其他网络的隐藏层可能使用 ReLU 等函数,并不要求所有层使用同一种激活函数。
8. 一次输入四条样本会发生什么
数据可以写成:
1 | x = np.array([ |
每行是一条样本,每列是一种特征,因此 x.shape 为 (4, 2)。
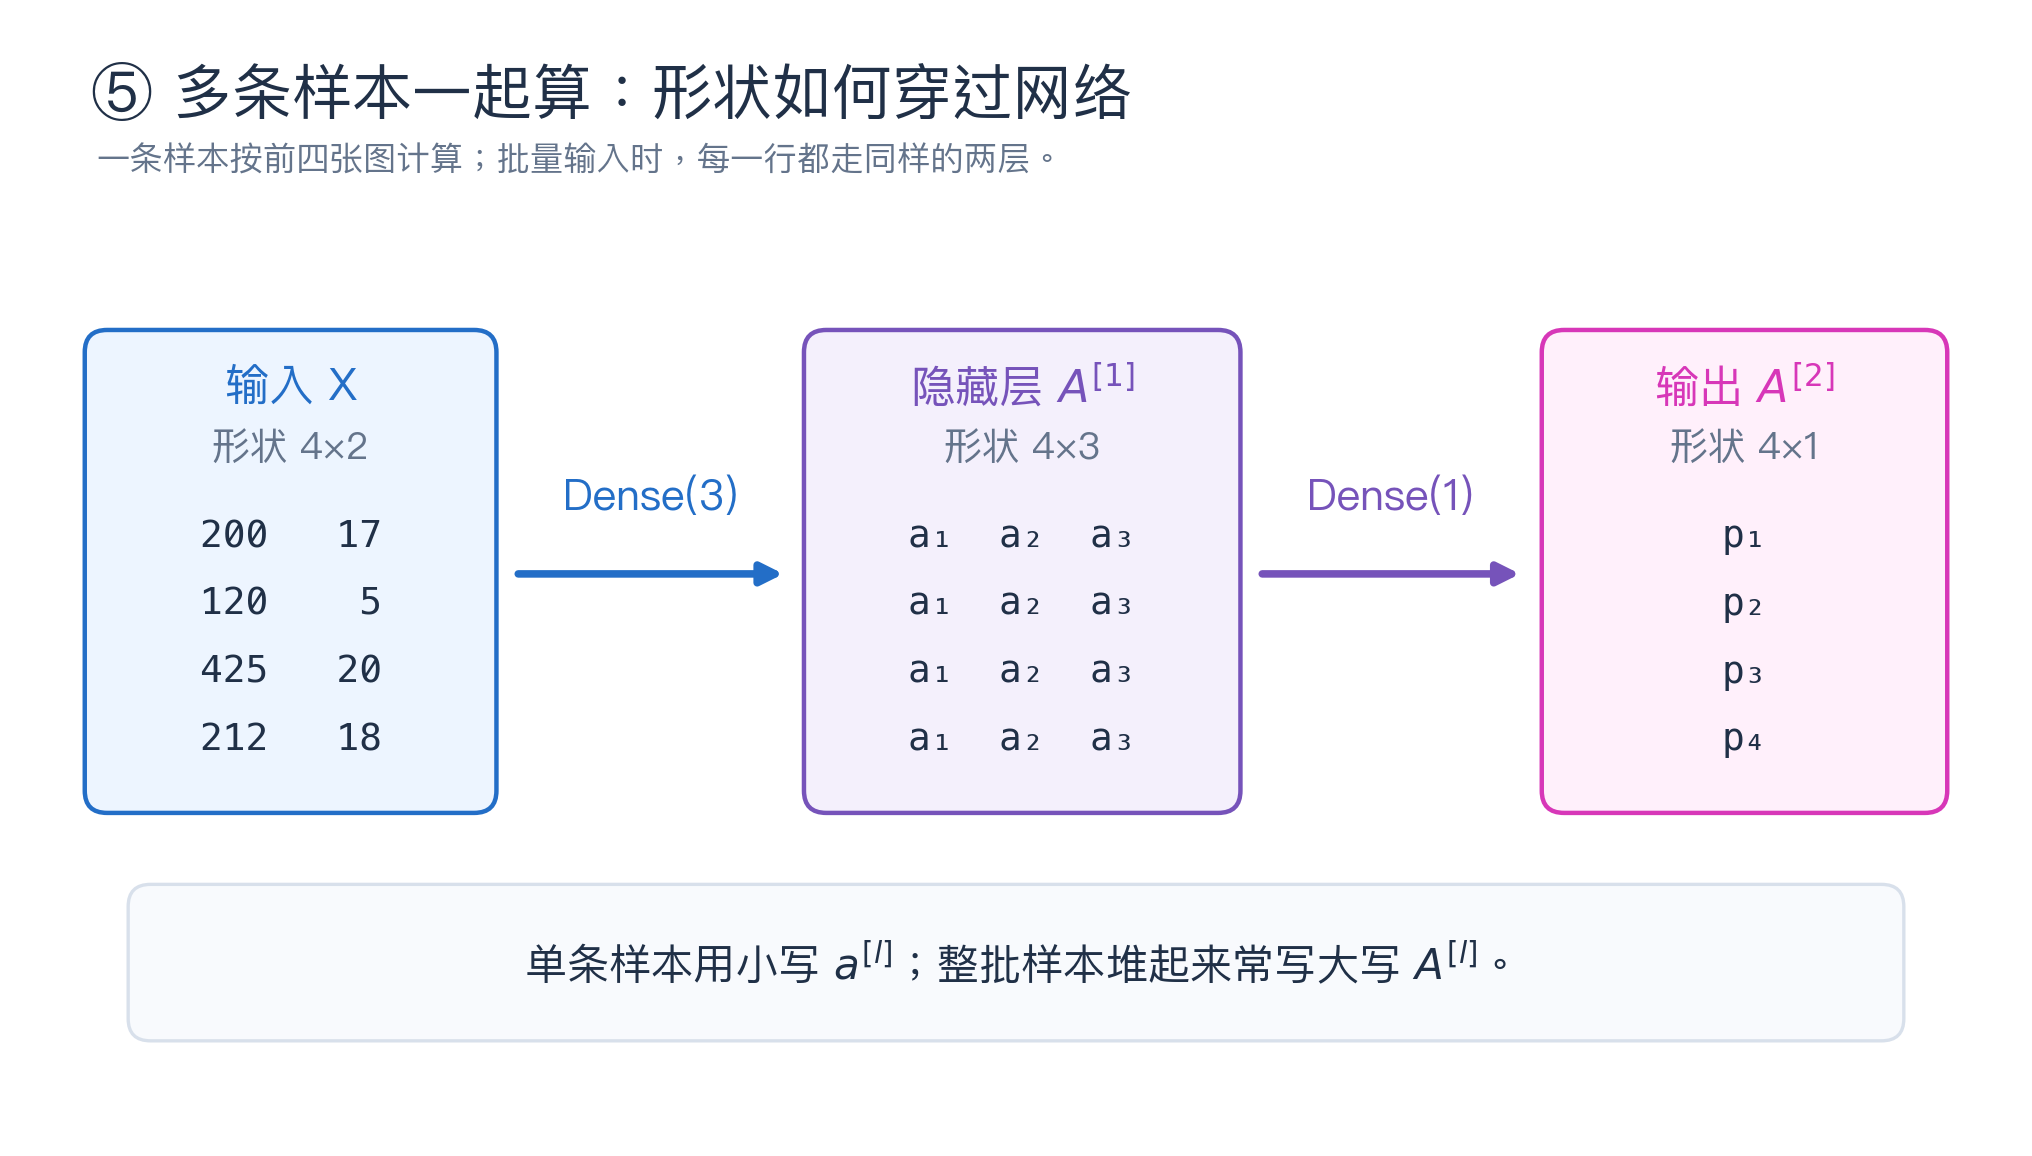
批量计算时,用大写 $A^{[\ell]}$ 表示把多条样本的激活向量按行堆起来:
$$
A^{[1]}=\sigma(XW^{[1]}+b^{[1]})
$$
$$
A^{[2]}=\sigma(A^{[1]}W^{[2]}+b^{[2]})
$$
| 位置 | 形状 | 含义 |
|---|---|---|
| 输入 X | (4, 2) |
4 条样本,每条 2 个特征 |
| 隐藏层 A[1] | (4, 3) |
每条样本得到 3 个激活值 |
| 输出层 A[2] | (4, 1) |
每条样本得到 1 个预测概率 |
所有样本共享同一套 $W$ 和 $b$,但各自的输入与结果不同。对于这个仅含 Dense 的网络,同一批中的其他样本不会参与某一条样本的前向计算。
图中的原始数据用于说明形状。若采用标准化,应对训练数据和预测数据应用同一套由训练集得到的参数;标准化不会改变以上形状。
9. 用 TensorFlow 复现前面的数值
下面只演示前向传播。通过手动设置权重,运行结果能与图中的数字对应;正常训练时,这些参数应由优化算法学习。
1 | import numpy as np |
layer_1(x) 会执行矩阵乘法、加偏置、应用 sigmoid。layer_2(a1) 再对第一层输出执行同样的三步。
对于这个简单顺序网络,model(x) 的计算等价于:
1 | layer_2(layer_1(x)) |
只做前向计算不需要先调用 compile() 或 fit()。本例已手动指定权重;如果既没有训练,也没有加载或设置权重,得到的是初始化参数下的输出。
10. compile、fit、predict 分别负责什么
| 调用 | 作用 |
|---|---|
model.compile(...) |
设置优化器、损失函数和评价指标 |
model.fit(x, y, ...) |
前向计算、计算损失、反向求梯度并更新参数 |
model.predict(x_new) |
使用当前参数前向传播,返回预测结果 |
model.evaluate(x_test, y_test) |
使用当前参数计算测试损失和指标 |
例如:
1 | model.compile( |
fit() 的一次参数更新包括:
- 由当前权重前向计算得到预测概率。
- 把预测概率与标签比较,计算二分类交叉熵。
- 通过反向传播计算各参数的梯度。
- 由优化器更新权重与偏置。
下一次前向传播使用更新后的参数。predict() 不进行这些参数更新。
model.fit(x, y) 默认训练轮数为 1。只有四条样本时,增加轮数主要能帮助拟合这些样本,不能证明模型掌握了普遍的烘焙规律。把训练中已出现的 [200, 17] 再拿来预测,也无法检验对新样本的泛化能力。
11. NumPy 与 Tensor 怎么衔接
NumPy 的 ndarray 与 TensorFlow 的 Tensor 都能表示多维数字数据。前者常用于整理数据,后者参与 TensorFlow 的计算、设备执行和自动求导。
1 | x = np.array([[0.5, 1.0]], dtype=np.float32) |
在本例常规的 eager 执行中,model(x) 返回 Tensor,model.predict(x) 返回 NumPy 结果。显示结果时调用 .numpy() 是常见做法。
若正在编写训练循环,计算损失的过程中应继续使用 TensorFlow 运算。中途转成 NumPy 再计算,会使那些 NumPy 运算脱离 TensorFlow 的自动求导记录。
12. 套回 25 → 15 → 1 的手写数字网络

这张课程图的完整结构是:
$$
x=a^{[0]}
\longrightarrow
a^{[1]}\ (25\text{ 个值})
\longrightarrow
a^{[2]}\ (15\text{ 个值})
\longrightarrow
a^{[3]}\ (1\text{ 个值})
$$
原始输入有多少特征取决于图像如何转换成像素向量,记为 $d$。不能从“第 1 层有 25 个神经元”推断原始输入只有 25 个特征。
第一隐藏层的第 $j$ 个神经元接收全部 $d$ 个输入:
$$
a_j^{[1]}
=g^{[1]}\left(
\sum_{k=1}^{d}x_kw_{kj}^{[1]}+b_j^{[1]}
\right),
\qquad j=1,\ldots,25
$$
第二隐藏层的第 $j$ 个神经元接收上一层的 25 个输出:
$$
a_j^{[2]}
=g^{[2]}\left(
\sum_{k=1}^{25}a_k^{[1]}w_{kj}^{[2]}+b_j^{[2]}
\right),
\qquad j=1,\ldots,15
$$
输出层只有一个神经元,接收上一层的 15 个输出:
$$
a_1^{[3]}
=\sigma\left(
\sum_{k=1}^{15}a_k^{[2]}w_{k1}^{[3]}+b_1^{[3]}
\right)
$$
展开求和:
$$
a_1^{[3]}=
\sigma\left(
a_1^{[2]}w_{11}^{[3]}
+a_2^{[2]}w_{21}^{[3]}
+\cdots
+a_{15}^{[2]}w_{15,1}^{[3]}
+b_1^{[3]}
\right)
$$
这就是截图中 $\mathbf{w}_1^{[3]}\cdot\mathbf{a}^{[2]}+b_1^{[3]}$ 的具体含义:15 个权重与 15 个激活值做点积,再加一个偏置。
截图把结果解释为“是数字 1”的概率,因此展示的是“数字 1 / 不是数字 1”的二分类。完整的 0~9 十分类通常需要另一种输出设计,例如 10 个输出配合 softmax。
一次输入 $m$ 条图像样本时,TensorFlow 的形状变化为:
$$
(m,d)\longrightarrow(m,25)\longrightarrow(m,15)\longrightarrow(m,1)
$$
13. 常见混淆
units=3 表示输出神经元数。输入维度由前一层决定。咖啡豆例子中 Dense(3) 接收 2 个特征,输出 3 个激活值。
编号不会规定神经元的含义。隐藏神经元不是预先分配为“温度神经元”“时间神经元”。每个隐藏神经元都可以组合全部输入,具体组合由权重决定。
$z$ 与 $a$ 处于激活函数的两侧。$z$ 是加权求和加偏置的结果,$a$ 是应用激活函数后的结果。
权重矩阵大小取决于两侧层宽。咖啡豆第一层有 $2\times3=6$ 个权重和 3 个偏置,共 9 个参数;第二层有 3 个权重和 1 个偏置,共 4 个参数,总计 13 个可训练参数。
$a_3^{[1]}$ 和 $a_1^{[3]}$ 位于不同位置。前者是第 1 层第 3 个神经元,后者是第 3 层第 1 个神经元。只有两层计算的咖啡豆网络里,没有 $a_1^{[3]}$。
参考资料
图中的标准化参数和数值权重为教学示例。