机器学习笔记
1.机器学习分类
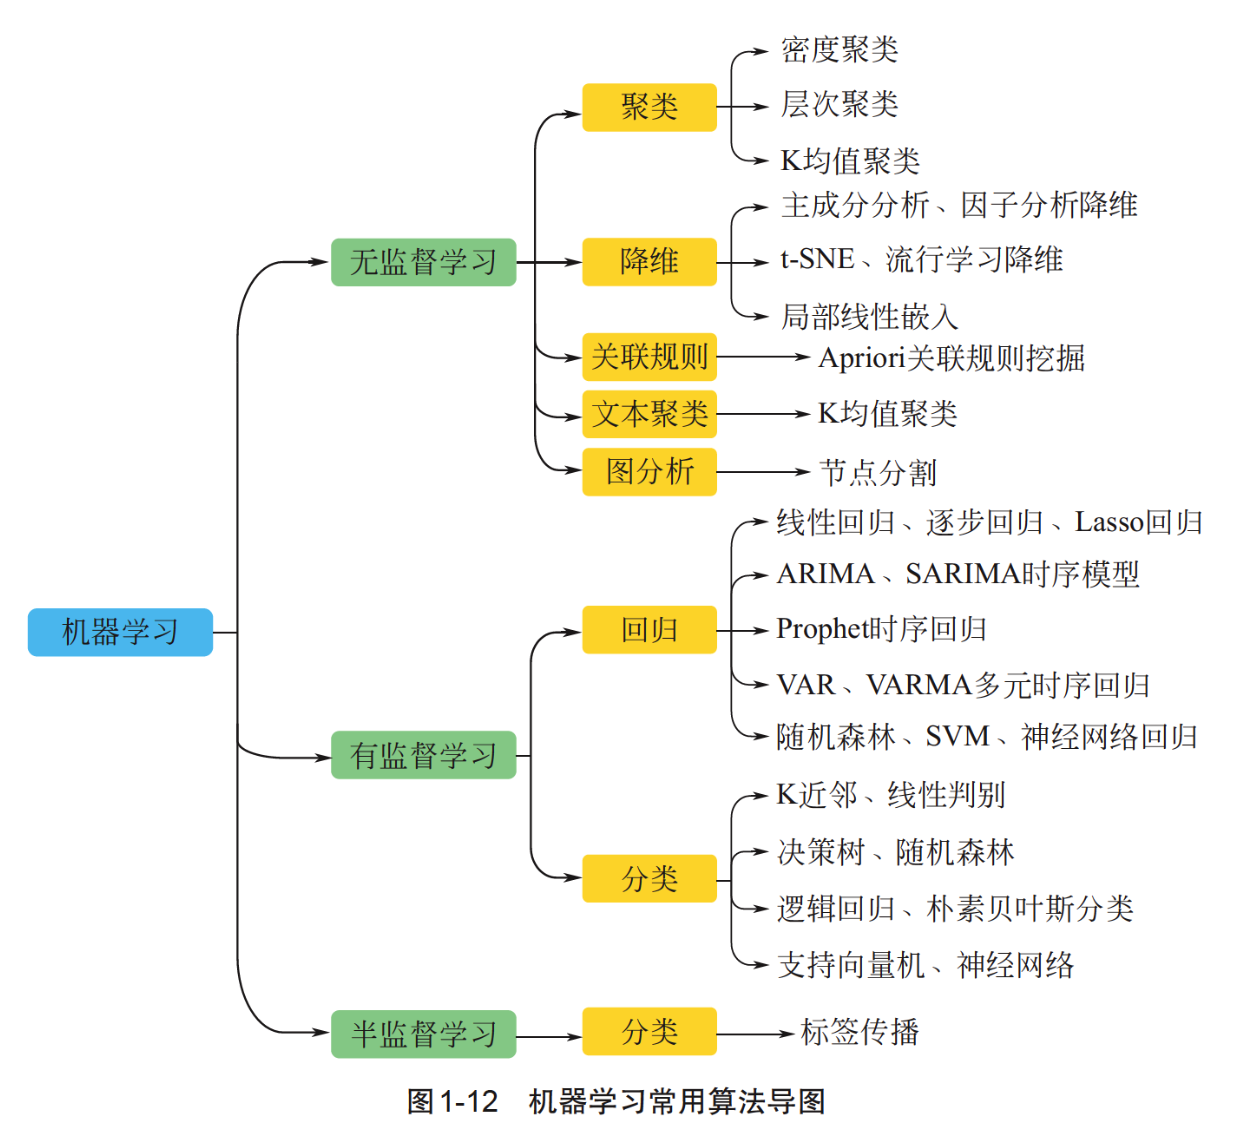
机器学习大致分为 监督学习,无监督学习两类
2.线性回归模型
真实值 预测值
在线性回归中,$f_{w,b}(x)$ 就是预测值 $\hat{y}$,两者表示相同的含义,即:
$$
\hat{y}=f_{w,b}(x)=wx+b
$$
其中,$x$ 是输入特征,$w$ 是权重或斜率,$b$ 是偏置或截距;$\hat{y}$ 表示模型计算出的预测值,$y$ 表示数据中的真实值。因此,模型的预测误差可以写成:
$$
\hat{y}-y=f_{w,b}(x)-y
$$
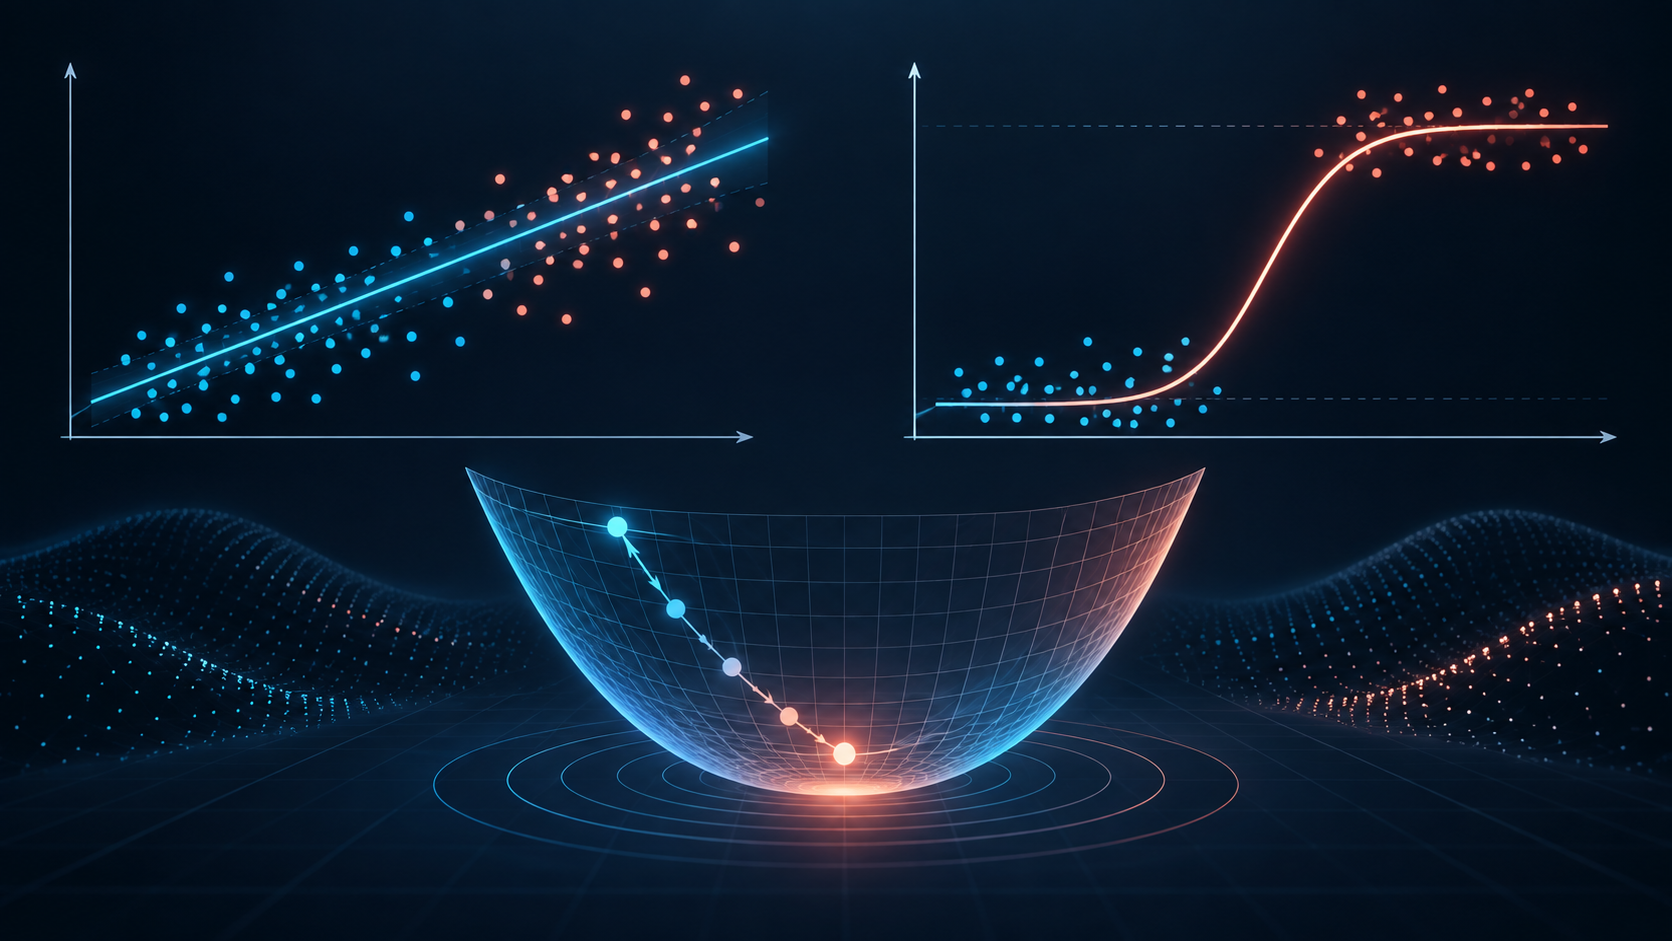
线性回归的目标是不断调整参数 $w$ 和 $b$,使预测值 $\hat{y}$ 尽可能接近真实值 $y$,从而减小代价函数 $J(w,b)$。
线性回归的代价函数 J(w,b)
在线性回归中,模型的预测函数为:
$$
f_{w,b}(x^{(i)})=wx^{(i)}+b
$$
其中,$w$ 表示直线的斜率,$b$ 表示截距,$x^{(i)}$ 表示第 $i$ 个样本的输入,$y^{(i)}$ 表示该样本的真实值。
为了衡量模型预测值与真实值之间的差距,通常使用平方误差代价函数:
$$
J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(f_{w,b}(x^{(i)})-y^{(i)}\right)^2
$$
把预测函数代入后,可以写成:
$$
J(w,b)=\frac{1}{2m}\sum_{i=1}^{m}\left(wx^{(i)}+b-y^{(i)}\right)^2
$$
其中:
- $m$:训练样本的数量;
- $f_{w,b}(x^{(i)})$:模型对第 $i$ 个样本的预测值;
- $y^{(i)}$:第 $i$ 个样本的真实值;
- $f_{w,b}(x^{(i)})-y^{(i)}$:预测误差;
- $J(w,b)$:所有训练样本的平均误差,用来评价模型的拟合效果。
公式中的误差需要平方,这样可以避免正负误差相互抵消,同时会让较大的误差受到更明显的惩罚。分母中的 $2$ 是为了在求导时抵消平方产生的系数,使后续计算更加简洁,不会影响代价函数最小值所在的位置。
线性回归训练的目标是寻找合适的 $w$ 和 $b$,使代价函数尽可能小:
$$
\min_{w,b}J(w,b)
$$
$J(w,b)$ 越小,说明预测值越接近真实值,模型的拟合效果通常越好。梯度下降算法就是通过不断调整 $w$ 和 $b$,逐步找到使 $J(w,b)$ 最小的参数。